Pinned

Better multimodal models need better spatial data.
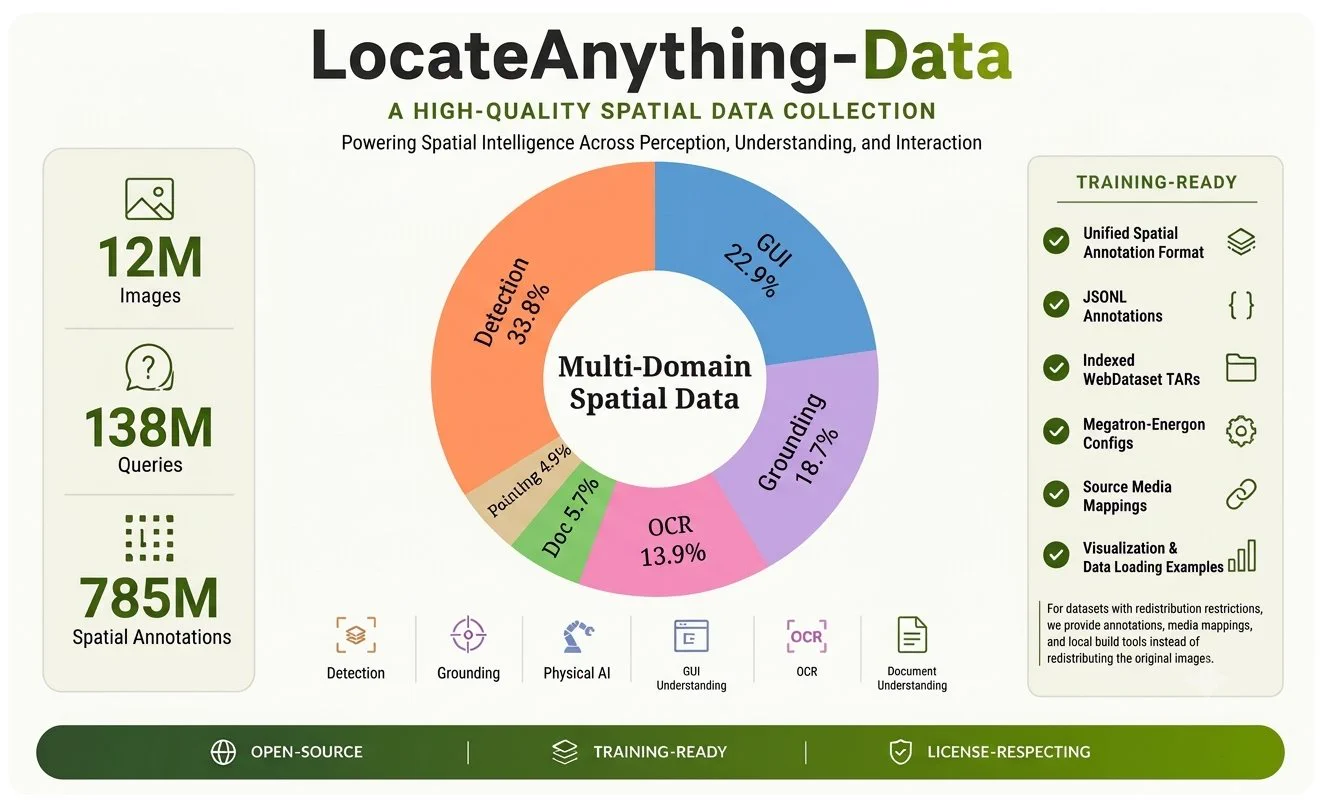
Today we’re open-sourcing LocateAnything-Data — a high-quality, training-ready spatial data collection with 12M images, 138M queries, and 785M annotations spanning multi-object detection, referring expression grounding, physical