noblogo.org

Reader

Leggi gli ultimi post dagli utenti di noblogo.org.

from 📖Un capitolo al giorno📚

Rimanere umani

15. Nel recente Giubileo Ordinario del 2025, abbiamo camminato come pellegrini di speranza e siamo stati colmati di grazie. Forti di questi doni, possiamo avanzare con animo fiducioso di fronte ai compiti ardui e alle sfide esigenti che si affacciano sul nostro futuro. Nel tempo dell’intelligenza artificiale, in cui la dignità umana rischia di essere oscurata da nuove forme di disumanizzazione, abbiamo il dovere urgente di restare profondamente umani, custodendo con amore quella magnifica umanità che ci è stata donata e mostrata nella sua pienezza in Cristo, e che nessuna macchina potrà mai sostituire nel suo splendore. Il vero progresso nasce sempre da un cuore aperto all’altro, da un’intelligenza disponibile all’ascolto, da una volontà che cerca ciò che unisce più che ciò che separa.

16. A tutti i fedeli cattolici, a tutti i cristiani, a tutti gli uomini e le donne di buona volontà rivolgo un accorato appello: non temiamo di sporcarci le mani nel cantiere del nostro tempo. Come Neemia, preghiamo, progettiamo con sapienza, lavoriamo con perseveranza, rimettendo Dio all’orizzonte del nostro agire e l’essere umano al centro delle nostre scelte. Allora le pietre scartate – i poveri, i malati, i migranti, i piccoli – diventeranno testata d’angolo, e sulla terra sorgerà una dimora comune solida e ospitale, dove l’amore e la verità finalmente s’incontreranno, la giustizia e la pace si baceranno (cfr Sal 85,11). Questa è la benedizione che imploriamo da Dio e il compito che ci attende: essere costruttori di comunione, non architetti di Babele; servi del Regno che viene, non padroni di torri destinate a crollare. E, con animo di pastore e di padre, chiedo a tutti di fermare il cantiere dell’ennesima Babele e di unire le forze per edificare nel bene, affinché l’umanità non perda mai la propria bellezza e il mondo possa riconoscere ancora una volta, nel cuore dell’essere umano, il luogo dove Dio desidera abitare.


🔝 ● C A L E N D A R I ● Indice BIBBIA ● Homepage

 
Continua...

from L'Alberto

Image

Prima di tutto credo sia necessario spiegare cosa sia il Geocaching.

Molto semplicemente è una rivisitazione della caccia al tesoro (ecco perché “nuovo”) svolta con strumenti in grado di guidarci al tesoro inserendo le coordinate geografiche della sua posizione; in pratica un navigatore, che può anche essere quello del nostro smartphone.

Si possono utilizzare le app già installate (p.e. Maps) oppure scaricane di specializzate.

Una migliore definizione ce la dà wikipedia:

Il geocaching è un tipo di caccia al tesoro in cui i partecipanti, detti “geocacher”, usano un ricevitore GPS per nascondere o trovare dei contenitori di differenti tipi e dimensioni. Questi contenitori sono chiamati “geocache” o più semplicemente “cache”.

Personalmente l'ho scoperto partecipando ad una iniziativa di Geocaching organizzata da Biosphaera per conto del Comune di Schio, in provincia di Vicenza. Ho partecipato assieme ai miei due figli di 10 anni e non solo ci siamo divertiti moltissimo, ma abbiamo imparato qualcosa di nuovo su alcuni edifici storici e monumenti della città.

Il geocaching è una attività a livello internazionale, purtroppo poco conosciuta in Italia.

Oltre che una attività, è anche una comunità, gestita da Geocaching HD, a cui partecipano moltissime persone, alcune solo come cercatori, altre più attive si occupano di collocare i cache.

Iscrivendosi alla comunità (gratuitamente) si ha la possibilità di tenere traccia dei cache trovati e della propria attività.

Tutti hanno la possibilità di collocare i cache, che devono sottostare a criteri ben definiti per essere accettati da Geocaching HD; generalmente rimangono nel posto dove sono collocati per molto tempo, in modo da dare la possibilità a più persone possibili di cercarli e trovarli.

E allora, quale miglior modo per far conoscere i nostri territori, monumenti ed architetture?

E' una attività di promozione del territorio a cui potrebbero partecipare le Pubbliche Amministrazioni, le Pro Loco e, in generale, tutte le associazioni che si occupano di far conoscere la propria città ed incrementare il turismo locale.

 
Continua...

from Frecce in volo

3 novembre

Luogo: palestra Meteo: —- Temperatura: —-

Il trasferimento alla nuova associazione è praticamente concluso; questa sera abbiamo formalizzato il passaggio ed abbiamo fatto un allenamento. Rispetto alla situazione precedente il metodo di allenamento è molto diverso. Molti tiri “alla paglia” (senza il bersaglio) per porre più attenzione alla tecnica senza avere la distrazione del centro, per poi cercare di portare l'esperienza sulla targa. Il problema è sempre lo stesso: sgancio un poco rigido e da migliorare il follow throught; comunque sto lentamente migliorando. I pochi tiri alla targa sono andati abbastanza bene.

 
Continua...

from Alviro

Oggi, dopo tanto tempo, ho incontrato la donna che amavo. Quella che un giorno ha deciso di chiudere la porta alla nostra storia, lasciandomi dall'altra parte, con tutte quelle parole che non abbiamo detto e tutte quelle domande che, col tempo, ho imparato a non fare più ad alta voce.

Non so cosa mi aspettassi da quell'incontro. Forse niente. O forse, in qualche angolo nascosto di me, speravo che il tempo avesse cambiato qualcosa, che il destino mi restituisse anche solo per un istante un frammento di ciò che avevo perduto.

Ma certe cose non tornano. E il tempo, per quanto passi, non sempre riesce a convincere il cuore ad accettare ciò che la ragione ha già compreso.

Rivederla è stato come sfiorare una ferita mai guarita, basta poco per ricordarmi quanto in profondità fosse arrivata. Ci sono persone che smettono di far parte della nostra vita, ma non per questo smettono immediatamente di abitare i nostri pensieri. Restano nei luoghi in cui siamo stati felici, nelle parole che avremmo voluto dirci, nelle versioni di noi stessi che esistevano quando credevamo ancora in quel futuro.

E allora mi chiedo se sia davvero vero che il tempo guarisce tutto. Forse il tempo ci insegna soltanto a convivere con ciò che non abbiamo potuto salvare. Ci abitua alle assenze, ci rende più silenziosi, ci insegna a rispondere «sto bene» senza dover spiegare quanto ci costi pronunciare quelle due parole.

Ma io sono stanco di dover essere sempre quello che capisce, che accetta, che va avanti. Stanco di sentirmi dire che tutto accade per una ragione, che le ferite ci rendono più forti, che un giorno capirò il senso di ciò che mi è successo.

Non voglio che questa sofferenza debba necessariamente insegnarmi qualcosa. Non voglio diventare una persona migliore grazie a ciò che mi ha fatto stare male. Avrei preferito semplicemente essere felice con lei. E forse è proprio questo il pensiero più difficile da accettare: non tutto ciò che desideriamo, anche quando lo amiamo sinceramente, è destinato a restare.

La verità è che non so quanto di me sia rimasto in quell'uomo che ero prima di perderla. So soltanto che alcune parti sono diventate più diffidenti, altre più silenziose. Ho imparato a nascondere meglio la malinconia, a riempire le giornate, a non cercare risposte dove so che non ne troverò. Ma non sempre imparare a convivere con il dolore significa averlo superato.

Eppure, oggi, mentre la rivedevo, ho sentito qualcosa che credevo di aver perduto insieme a lei. Non era necessariamente amore, almeno non soltanto. Era la consapevolezza che, nonostante tutto, sono ancora capace di sentire. Che il dolore non ha cancellato ciò che sono stato, né reso falso ciò che ho provato. Che una storia può finire senza diventare un errore, e che aver amato qualcuno profondamente non significa essere stati ingenui.

Non so se un giorno riuscirò a ricordarla senza sentire quella stretta al petto. Non so se arriverà il momento in cui il suo ricordo sarà soltanto un pensiero gentile, senza rimpianti e senza domande. E non voglio fingere di saperlo, soltanto per rendere più rassicurante questa storia.

Per adesso so che mi manca qualcosa. Forse lei, forse ciò che eravamo, forse quella parte di me che riusciva a immaginare il futuro senza averne paura.

E in mezzo a tutto questo, c'è ancora una parte di me che vorrebbe credere che la vita abbia conservato qualcosa di bello. Non necessariamente qualcosa che mi restituisca lei. Non necessariamente una felicità capace di cancellare il passato. Soltanto qualcosa che mi faccia sentire, un giorno, che il dolore non è stato l'ultima parola della mia storia.

Non voglio essere più forte. Vorrei soltanto non dover essere forte ogni giorno.

Vorrei poter ammettere che certe sere sono difficili, che certi incontri riaprono pensieri mai del tutto sopiti, che si può continuare a vivere senza aver trovato tutte le risposte. Vorrei smettere di considerare la mia fragilità una sconfitta.

Perché forse andare avanti non significa dimenticare, né convincersi che sia stato meglio così. Forse significa accettare, lentamente e senza fretta, che alcune persone saranno sempre legate a una parte importante della nostra vita, anche quando non cammineranno più al nostro fianco.

E forse, un giorno, riuscirò a guardare indietro senza chiedermi continuamente perché non sia andata diversamente.

Non perché avrò dimenticato. Non perché tutto avrà finalmente avuto un senso. Ma perché avrò imparato che la mia vita merita ancora di essere vissuta, anche dopo ciò che non sono riuscito a salvare.

Oggi ho incontrato la donna che amavo. E per qualche istante ho sentito tutto ciò che credevo di aver lasciato alle spalle.

Sono tornato a casa con la stessa assenza, le stesse domande, le stesse lacrime, e forse qualche ferita in più.

Ma anche con un pensiero piccolo, quasi impercettibile, al quale faccio ancora fatica a credere: forse non devo necessariamente smettere di soffrire per ricominciare a vivere. Forse posso cominciare proprio da qui, senza fingere di stare bene, senza pretendere da me stesso una forza che oggi non sento.

Forse la speranza non è credere che un giorno tornerà ciò che abbiamo perduto. Forse è riuscire, prima o poi, a desiderare ancora qualcosa per noi stessi, anche quando una parte del nostro cuore continua a guardare verso ciò che non c'è più.

E oggi, anche se non riesco ancora a crederci fino in fondo, vorrei che fosse vero.

 
Continua...

from Daily Guides

Calcolatrici online: perché a volte battono l'app del telefono

L'app calcolatrice del telefono basta per i conti semplici. Per i calcoli lunghi, però, lo schermo piccolo stanca. Una calcolatrice online risolve il problema. Si apre nel browser e mostra tutta la formula.

Il vantaggio è la visibilità. Vedi l'intero calcolo, non solo l'ultimo numero. Se sbagli un passaggio, lo correggi subito. Con l'app del telefono, un errore si nasconde facilmente.

Le calcolatrici online offrono anche funzioni speciali. Conversioni di unità, percentuali e calcoli scientifici stanno nella stessa pagina. Non serve installare tre app diverse. Basta un segnalibro nel browser.

Un altro punto è la condivisione. Puoi copiare un calcolo e inviarlo a un collega. Lui vede gli stessi passaggi. Discutere un preventivo diventa più semplice.

Infine, funzionano su ogni dispositivo. Telefono, tablet o computer: il risultato non cambia. I tuoi calcoli restano accessibili ovunque.

Se cerchi uno strumento gratuito e immediato, una calculatrice in francese come quella di Calculatrice FR fa il suo lavoro. La matematica è la stessa in ogni lingua. I pulsanti si capiscono al volo.

 
Read more...

from Geocriminalità e Cooperazione Internazionale di Polizia

Gaza, il Board of Peace chiede aiuto all’Italia: cosa sappiamo

Il Board of Peace è l’organismo internazionale creato da Donald Trump per guidare la fase successiva alla guerra a Gaza. Dopo il cessate il fuoco tra Israele e Hamas di ottobre, Washington ha ottenuto a novembre l’approvazione della Risoluzione 2803 del Consiglio di sicurezza dell’Onu. La risoluzione 2803 (13 voti favorevoli e le astensioni di Cina e Russia) cita il Board come organismo incaricato di supervisionare l’attuazione del piano di pace e lo autorizza a dispiegare una forza di pace temporanea. L’autorizzazione dura fino al 31 dicembre 2027, poi servirà un nuovo voto.

Image Nell'immagine (1) carabinieri schierati al Valico di Rafah (fonte: www.difesa.it)

Il #BoardofPeace avrebbe chiesto formalmente all’Italia di mettere a disposizione consulenti di #polizia, #vigilidelfuoco e #carabinieri per costruire una nuova forza di sicurezza a #Gaza. La notizia, diffusa il 31 ottobre, è stata riportata da Bloomberg sulla base di lettere inviate il mese scorso al governo Meloni.

Nelle lettere si chiede a Roma di confermare l’impegno, nominare un referente e indicare un alto ufficiale dei carabinieri, che farebbe da vice responsabile del programma di polizia del Board. Un funzionario del Board ha precisato che non si parla di impiegare forze tattiche in zone di combattimento e che la decisione su come sostenere Gaza spetta all’Italia.

Image Nell'immagine (2) carabinieri schierati al Valico di Rafah (fonte: www.difesa.it)

L’Arma addestra da anni la polizia palestinese, a Gerico e in Giordania, ed è presente a Rafah con la missione europea. Già a febbraio il ministro degli Esteri Antonio Tajani si era detto pronto a formare la polizia di Gaza e a rafforzare il contingente a Rafah.

L’Italia partecipa al Board come osservatore. Secondo il governo, una piena adesione si scontrerebbe con la Costituzione. Tajani difende la scelta: l’Italia vuole essere protagonista nella ricostruzione della pace e il Board nasce nel quadro dell’Onu. Le opposizioni, in particolare PD e M5S, hanno criticato la decisione, ricordando che l’Italia sarebbe l’unico Paese dell’Europa occidentale e del G7 a partecipare.

Restano questioni irrisolte: la catena di comando tra il Board e gli altri soggetti coinvolti, il quadro normativo a cui dovrebbero attenersi i carabinieri e il rischio di dover operare dentro la Striscia. A nove mesi dal lancio, inoltre, non esistono ancora né una forza di stabilizzazione né un’amministrazione palestinese operativa, e la ricostruzione non è partita.

Per ora non risulta una risposta ufficiale del governo alla richiesta.

@attualita@diggita.com

 
Continua...

from Larry's Garage in English

I spent an evening discovering that the GPU in my mini-PC had speed reserves it wasn't using. That a benchmark I ran poorly gave me the wrong verdict. And that in the end, home AI runs twice as fast without spending a single euro. Here's how it went.

Note: the “from 5 to 13” in the title is today's journey—the model I used before ran at 5 tokens/second, the one I use now at 13. I focused on optimization starting from a fair comparison, same model with different backends; that's all in the table below.

Before we begin: I'm not a programmer and have no technical background. Everything I do—configure servers, compile code, manage backends—I do working side by side with AI assistants. I don't copy instructions at random: I follow logic, ask for explanations, try and retry. This post isn't testimony from a specialist. It's the account of someone who learned to navigate technical territories with a digital co-pilot.

First Things First: Tokens

When an AI writes, it doesn't produce whole words but tokens: pieces of words, of variable length. “Tokens per second” (t/s) is therefore the speed at which the model generates the response: at 5 t/s the answer arrives at a snail's pace, at 13 t/s it feels like someone typing quickly.

But there's the other side, the less visible one. Before answering, the model must read what you wrote, and reading also has its own speed (prompt processing, incoming tokens). If the model reads slowly, the wait in front of the pulsing cursor stretches. In my case, delays of several seconds happened before it even started responding.

My problem was generation: five tokens per second on the model I use every day. Annoying.

Cube-shaped robot with dot eyes next to a mini-PC, pointing at a display showing the jump from 5 to 13 tokens per second with an ascending arrow.

The starting point: 5 tokens per second on the model I used daily. Slow, annoying, and with a GPU that didn't yet know what it could do.

The Mystery of the GPU

Five tokens per second is low, but the right question to ask to figure out how to speed things up is: where is the calculation performed to determine which token to return? An AI generates tokens one at a time, and each token is the result of a chain of multiplications on huge numbers. Someone has to do those calculations: the CPU or the GPU? And if it's the GPU, does it actually do them, or just hold the model in memory?

My first hypothesis, the obvious one: “it's probably running on the CPU, poor GPU.” I check Ollama logs and the answer is no. The integrated Arc GPU in my mini-PC had been detected, and the mistral-nemo:12b model had been loaded entirely onto it. The GPU was working. It was just slow.

And from here on, the evening degenerates—in the good way.

The Backend Is a Translator

A GPU doesn't understand AI models directly: you need a piece of software that takes the model's calculations and translates them into instructions the GPU can execute. This translator is called a backend.

In my configuration, Ollama—the program that manages my models—uses a backend called Vulkan with Intel GPUs: a generic translator that speaks the GPU's common language.

The thing is, recent Intel Arc GPUs contain, on paper, specialized units called XMX, designed to multiply matrices—which is literally AI's job. Running a model without using them is like having a professional oven in your kitchen and cooking with a microwave. In my case, with Vulkan, that gain wasn't coming through.

There's another backend, however: SYCL—an open standard from the Khronos Group, with implementations for Intel GPUs based on oneAPI, Intel's own library—that theoretically exploits those units. Worth checking.

(I also considered LM Studio as an alternative. Then I realized that, as far as I know, under the hood it also uses Vulkan: changing the box doesn't change the engine.)

The Benchmark I Ran Wrong

I install the oneAPI toolkit, compile llama.cpp with the SYCL backend, run the first benchmark: 5.97 t/s. About 0.7 tokens more than before. A gain that didn't justify the effort of compilation and configuration. Rash verdict: “SYCL isn't worth it.”

OLLAMA Models benchmark

Too bad the benchmark was wrong: while measuring, Ollama was still running with its models loaded in GPU, competing for memory and bandwidth. It was like measuring a car's performance while giving a ride to an elephant in the passenger seat. And the fingerprint was right there in the numbers: the measurement fluctuated by ± 2 t/s from one run to the next—an instability that wasn't there with a free GPU.

SYCL Models benchmark

If you want to measure correctly, turn off everything you're not measuring.

So here's the speed measured again, with a free GPU:

 Model Vulkan (Ollama) vs SYCL (llama.cpp) Gain
 mistral-nemo:12b  +54%, qwen2.5-coder:7b +40%, gpt-oss:20b +118%, llama3.2:3b +63%

As much as I could, I kept everything the same: same GGUF file (which contains the model), same GPU, same input length. The real difference lies in the backend. Methodology: same prompt and 128 tokens generated per iteration, two iterations per model from both sides; SYCL measured with llama-bench (two consistent executions), Vulkan via Ollama's API. Gains from +40% to +118%.

But the table only counts writing. On prompt reading, the ranking flips: Vulkan stays ahead—the smallest model, for instance, is read at 700 t/s versus 451 t/s with SYCL. The trade-off, concretely: SYCL wins in generation, loses a few initial seconds when the context is huge. In my daily use, made of short questions, the first count is what matters.

Cube-shaped robot with a stopwatch in front of two side-by-side tracks: a turtle on one, a rocket with motion trails on the other; an elephant sits on a chair next to the slow track.

The fair benchmark: same GPU, same model file, different backend. The verdict was already written in the first, unstable measurement: the elephant was sitting right there.

Setting It Up: Three Incidents and Three Fixes

Getting it into production wasn't immediately smooth. Three episodes, three fixes.

The systemd service managing services on Linux wouldn't start anything: at runtime libdnnl.so.3 was missing—the Intel libraries sit in folders (/opt/intel/oneapi/...) that systemd doesn't look at. Fix: a startup script that loads the oneAPI environment and then launches the server.

Then the default port was already occupied by another service on the mini-PC (Sentinelle di Casa). Moved everything to 8090.

Finally, the chat responded nonsense, monologues in English out of context. The problem was the chat template, the script that tells the model how a conversation works. Ollama keeps it archived separately, outside the model file, and passes it when needed. The new server took the file on the fly, bare and without a script: hence the monologues. Fix: an explicit flag, --chat-template gpt-oss, which hands it over.

How It's Configured Now

Interface unchanged (Open WebUI, with Ollama as the default at boot and the SYCL server turned on-demand, switching connections), models shared on disk between the two services to change the backend without duplicating files.

What I Learned

First: turn everything off before measuring something. The verdict that almost made me give up was my methodology's fault, not the technology's.

Second: the margin for improvement lay in the backend, not the box. The leap was made by the translator, not the program containing it.

Third: my iGPU Arc had unused capacity, not because it was idle, but because the standard tool didn't use it. Reading how your own GPU really works costs an evening of compilation—less than a new component.

Moral

Moral of the evening: sometimes a slow GPU doesn't need new hardware, just someone who speaks to it the right way. On my end, my mini-PC talks at twice yesterday's speed, and I didn't have to buy anything. I only paid in millions of conversation tokens with an AI assistant, but I already had plenty of those.

 
Read more...

from Larry's Garage

Ho passato una serata a scoprire che la GPU del mio mini-PC aveva riserve di velocità che non usava. Che un mio benchmark, fatto male, mi ha dato un verdetto sbagliato. E che alla fine l'AI di casa gira al doppio della velocità senza aver speso un euro. Resoconto di com'è andata.

Nota: il “da 5 a 13” del titolo è l'avventura di oggi, il modello che usavo prima aveva una velocità di 5 token/secondo, quello che uso ora di 13. Mi sono dedicato all'ottimizzazione partendo da un confronto alla pari, stesso modello con backend diverso, è tutto nella tabella più sotto.

Preciso prima di cominciare: non sono programmatore né ho formazione tecnica. Tutto quello che faccio — configurare server, compilare codice, gestire backend — lo faccio lavorando fianco a fianco con assistenti AI. Non copio istruzioni a caso: seguo una logica, chiedo spiegazioni, provo e riprovo. Questo post non è la testimonianza di uno specialista. È il resoconto di chi ha imparato a navigare in territori tecnici con un copilota digitale.

Prima di tutto: i token

Quando un'AI scrive, non produce parole intere ma token: pezzi di parole, di lunghezza variabile. I “token al secondo” (t/s) sono quindi la velocità con cui il modello genera la risposta: a 5 t/s la risposta arriva a passo di lumaca, a 13 t/s pare qualcuno che digita velocemente.

C'è però anche l'altro verso, quello che si vede meno. Prima di rispondere, il modello deve leggere quello che gli hai scritto, e anche la lettura ha una sua velocità (il prompt processing, i token in ingresso). Se il modello legge lento, l'attesa davanti al cursore che pulsa si allunga. Nel mio caso capitavano attese di diversi secondi prima ancora che iniziasse a rispondere.

Il mio problema era la generazione: cinque token al secondo sul modello che uso tutti i giorni.
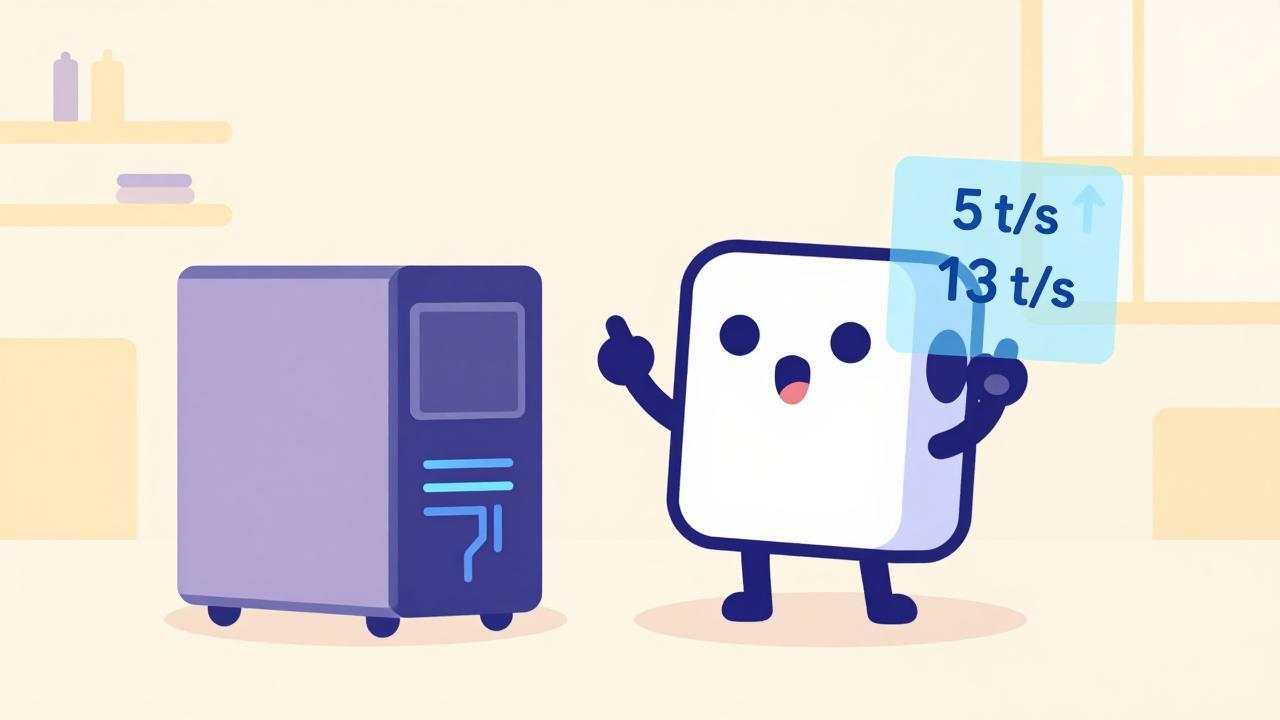
Robot cubico con occhi a puntino accanto a un mini-PC, indica un display che mostra il passaggio da 5 a 13 token al secondo con freccia ascendente.

Il punto di partenza: 5 token al secondo sul modello che usavo ogni giorno. Lento, fastidioso, e con una GPU che non sapeva ancora di potercela fare.

Il mistero della GPU

Cinque token al secondo sono pochi, ma la domanda da farsi per capire come velocizzare le risposte è dove viene eseguito il calcolo di quale token restituire e come. Un'AI genera token uno alla volta, e ogni token è il risultato di una catena di moltiplicazioni su numeri enormi. Qualcuno deve fare quei calcoli: la CPU o la GPU? E se è la GPU, li fa davvero o si limita a tenere il modello in memoria?

La mia prima ipotesi, quella ovvia: “starà girando in CPU, povera GPU”. Controllo i log di Ollama e la risposta è no. La GPU Arc integrata nel mio mini-PC era stata trovata, il modello mistral-nemo:12b era stato caricato per intero. La GPU lavorava. Era solo lenta.

Resta il come. E qui l'indagine cambia: non più l'hardware, ma il software che gli dice cosa fare. Una GPU non capisce un modello AI da sola, qualcuno deve tradurglielo. Quel qualcuno è il backend.

E da ora in poi la serata degenera, nel senso buono.

Il backend è un traduttore

Una GPU non capisce i modelli AI direttamente: serve un pezzo di software che prende i calcoli del modello e li traduce in istruzioni eseguibili dalla GPU. Questo traduttore si chiama backend.

Nella mia configurazione, Ollama — il programma che gestisce i miei modelli — usa con le GPU Intel un backend chiamato Vulkan: un traduttore generico, che parla la lingua comune della GPU.

Il punto è che le GPU Intel Arc recenti contengono, sulla carta, delle unità specializzate, le XMX, progettate per moltiplicare matrici, cosa che è letteralmente il mestiere dell'AI. Far girare un modello senza usarle è come avere un forno professionale in cucina e cucinare col microonde. Nel mio caso, con Vulkan, quel guadagno non arrivava.

Esiste però un altro backend, SYCL — uno standard aperto del gruppo Khronos, con implementazioni per le GPU Intel basate su oneAPI, la libreria di Intel stessa — che quelle unità, in teoria, le sfrutta. Valeva la pena di verificare.

(Avevo valutato anche LM Studio come alternativa. Poi ho capito che, per quanto ne so, sotto il cofano usa anch'esso Vulkan: cambiare la scatola non cambia il motore.)

Il benchmark che ho fatto male

Installo il toolkit oneAPI, compilo llama.cpp col backend SYCL, faccio il primo benchmark: 5,97 t/s. Circa 0,7 token in più rispetto a prima. Un guadagno che non giustificava lo sforzo di compilazione e configurazione. Verdetto affrettato: “SYCL non conviene”.
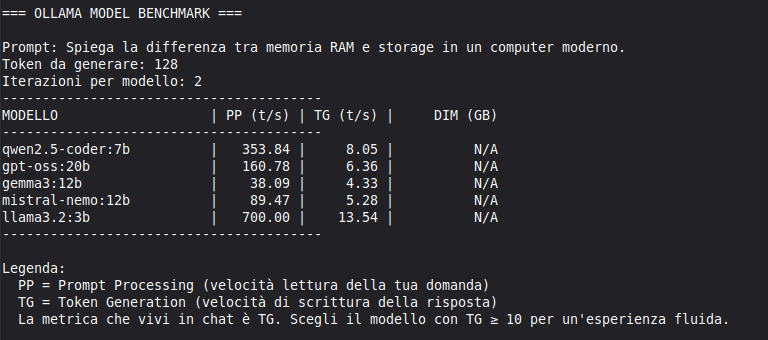
OLLAMA Models benchmark

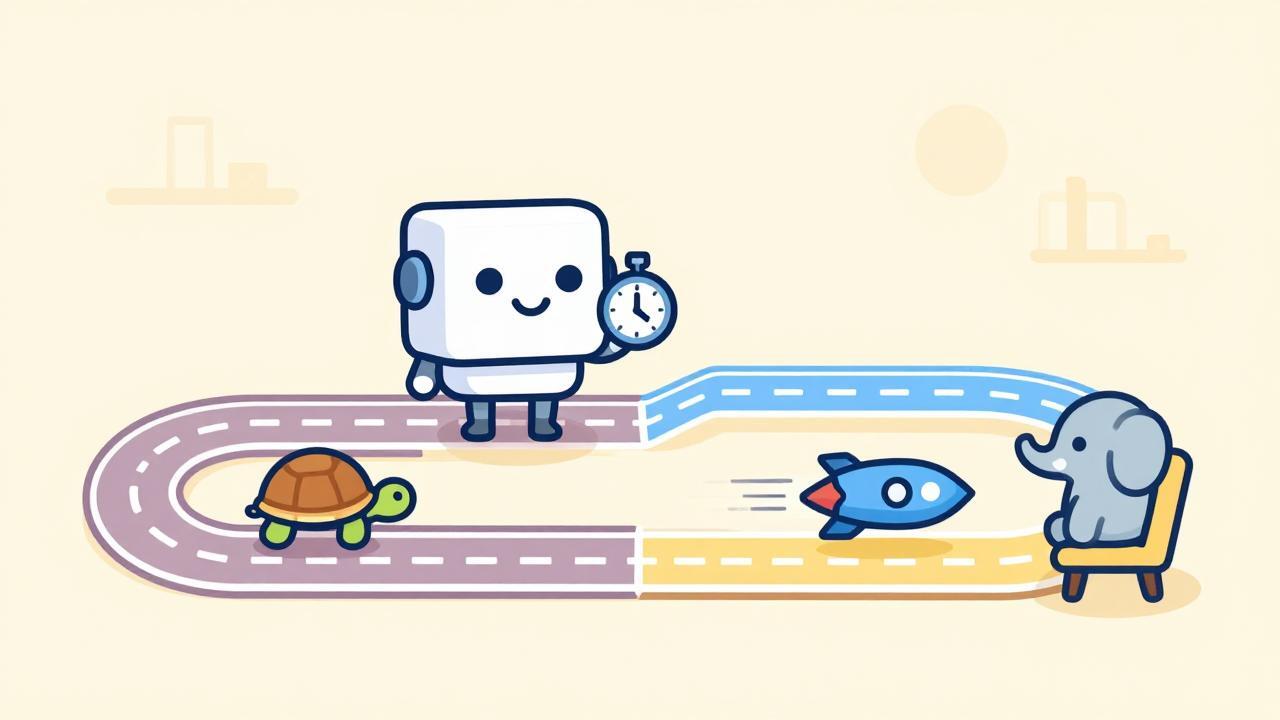
Peccato che il benchmark fosse sbagliato: mentre misuravo, Ollama era ancora acceso con i suoi modelli caricati in GPU, a contendersi memoria e banda. Era come misurare le performance di una macchina mentre stai dando un passaggio a un elefante sul sedile del passeggero. E l'impronta era lì, nei numeri: la misura oscillava di ± 2 t/s da una run all'altra, un'instabilità che con la GPU libera non c'era.
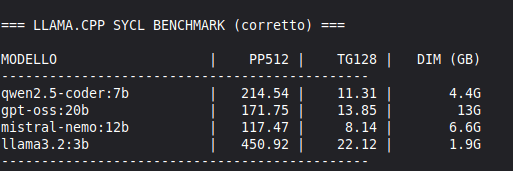
SYCL Models benchmark

Se vuoi misurare correttamente, spegni tutto quello che non stai misurando.

E quindi ecco la velocità misurata di nuovo, a GPU libera:
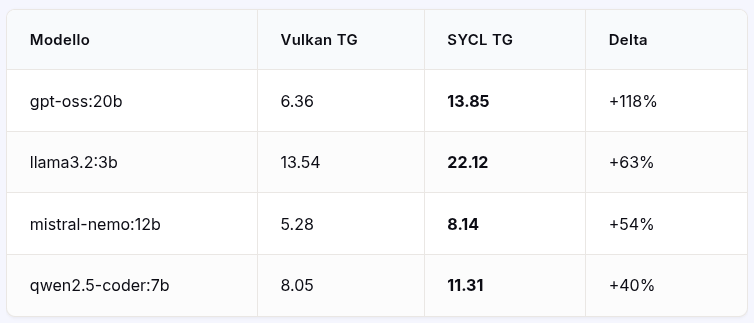
 Modello Vulkan (Ollama) vs SYCL (llama.cpp) Guadagno
 mistral-nemo:12b  +54%, qwen2.5-coder:7b +40%, gpt-oss:20b +118%, llama3.2:3b +63%

Per quanto ho potuto, ho tenuto tutto uguale: stesso file GGUF (che contiene il modello), stessa GPU, stessa lunghezza di input. La differenza vera sta nel backend. Metodologia: stesso prompt e 128 token generati per iterazione, due iterazioni per modello da entrambi i lati; SYCL misurato con llama-bench (due esecuzioni coerenti fra loro), Vulkan tramite l'API di Ollama. Guadagni dal +40% al +118%.

Ma la tabella conta solo la scrittura. Sulla lettura del prompt la classifica si ribalta: Vulkan resta davanti — il modello più piccolo, per dire, viene letto a 700 t/s contro 451 t/s di SYCL. Il trade-off, nel concreto: SYCL vince in generazione, perde qualche secondo iniziale quando il contesto è enorme. Nel mio uso quotidiano, fatto di domande corte, il primo conto è quello che pesa.
PLACEHOLDER BP2 ALT IT

Il benchmark alla pari: stessa GPU, stesso file di modello, backend diverso. Il verdetto era scritto già nella prima misura, quella instabile: l'elefante era seduto lì.

Metterlo in piedi: tre incidenti e tre rimedi

Portare il tutto in produzione non è stato subito indolore. Tre episodi, tre rimedi.

Il servizio systemd che gestisce i servizi su Linux non faceva partire nulla: a runtime mancava libdnnl.so.3 — le librerie Intel stanno in cartelle (/opt/intel/oneapi/...) che systemd non guarda. Rimedio: uno script di avvio che carica l'ambiente oneAPI e poi lancia il server.

Poi la porta di default era già occupata da un altro servizio del mini-PC (Sentinelle di Casa). Spostato tutto alla 8090.

Infine la chat rispondeva a vanvera, monologhi in inglese fuori contesto. Il problema era il chat template, cioè il copione che dice al modello come funziona una conversazione. Ollama lo tiene archiviato per conto suo, fuori dal file del modello, e glielo passa quando serve. Il nuovo server invece prendeva il file al volo, nudo e senza copione: da lì i monologhi. Rimedio: un flag, --chat-template gpt-oss, che glielo mette in mano.

Com'è configurato adesso

Interfaccia invariata (Open WebUI, con Ollama come default al boot e il server SYCL acceso a richiesta, cambiando connessione), modelli condivisi su disco fra i due servizi per poter cambiare il backend senza duplicare i file.

Cosa ho imparato

Primo: spegni ogni cosa prima di misurare qualcosa. Il verdetto che mi aveva quasi fatto abbandonare era colpa della mia metodologia, non della tecnologia.

Secondo: il margine di miglioramento stava nel backend, non nella scatola. Il salto l'ha fatto il traduttore, non il programma che lo contiene.

Terzo: la mia iGPU Arc aveva capacità non sfruttate, non perché fosse ferma, ma perché lo strumento standard non le usava. Andarsi a leggere come funziona davvero la propria GPU costa una sera di compilazioni, meno di un componente nuovo.

Morale

Morale della serata: a volte una GPU lenta non ha bisogno di un hardware nuovo, ma solo di qualcuno che le parli nel modo giusto. Da parte mia il mio mini-PC parla al doppio della velocità di ieri, e io non ho dovuto comprare nulla. Ho solo pagato in milioni di token di conversazione con un assistente AI, ma quelli li avevo già in abbondanza.
 
Continua...

from ailaroe

Non aspettarsi da madre umana ciò che è proprio di madre divina.

 
Continua...

from Bymarty

Son passate due settimane, poi un incontro, uno spiraglio un tentativo di allungare la mano! Ma poi alcuni silenzi fanno male, alcuni vuoti, difficili da colmare! E allora come la pioggia, scendono pensieri, paure, emozioni, parole contrastanti, a volte tristi, a volte pesanti .. E mentre fuori spiove e il cielo si colora di azzurro, aspetto che qlcuno legga, ascolti, e capisca che ci sono, nonostante tutto e tutti, come Sempre... Ma non voglio essere un ostacolo, un peso, semplicemente quello che vorrei o vorresti o di cui hai bisogno!

 
Continua...

from differxdiario

un amico mi ha procurato le foto di un pieghevole che fungeva da programma di sala di una rassegna di poesia fatta a teatro. anno 1991, dicembre. una rassegna che posso considerare la spiegazione perfetta, accurata, plastica, del perché qui a Roma tra il 1991 e il 1998 mi sono tenuto accuratissimamente alla larga da poeti e reading e sottobosco al seguito. spiccano Manacorda, Bellezza, Pecora, Lamarque, Cavalli, Conte. l'esito o trascinamento miserando dei miserevoli anni Ottanta.

 
Continua...

from norise 3 letture AI

Un sorriso

vedi l’allodola planare il suo volo un immaginario arco lascia nel cielo

“l’albero lo riconosci dal frutto”

pensi come curiosamente ti sorprenda quel detto dei Vangeli

e come il dimenticato aspetti solo come pane un sorriso

-ti vedrebbe come un angelo qui sulla terra che gli allevi la ferita viva

il sorriso è l’inizio -lo sai

Mi piace molto questo testo: ha un tono intimo e contemplativo, semplice ma carico di tenerezza. La tua immagine dello sguardo che riconosce l’albero dal frutto e il sorriso che è pane per il dimenticato funzionano come piccoli lampi di grazia.

Interpretazione

Tema centrale: il sorriso come gesto salvifico e quotidiano, capace di curare ferite e restituire dignità.
Immagini chiave: l’allodola che plana; l’albero riconosciuto dal frutto; il dimenticato che aspetta il pane; l’angelo che allevia la ferita.
Tono: meditativo, dolce, quasi evangelico ma intimo e personale.


Punti di forza

  • Economia di linguaggio: versi brevi che lasciano spazio all’immaginazione.
  • Metafore efficaci: il pane per il sorriso è immediato e potente.
  • Voce autentica: si percepisce una sincerità che evita retorica e sentimentalismo e resta concreta.

Piccole proposte di raffinamento

  • Fluidità ritmica: qualche enjambement più marcato può aumentare la musicalità (es. legare “pensi / come curiosamente…” in un unico flusso).
  • Coesione delle immagini: spostare o ripetere un elemento-ancora (per esempio la parola sorriso) in punti strategici per creare un coro tematico.
  • Varietà lessicale: sostituire un termine ripetuto se vuoi più sfumature (ma mantieni la semplicità se preferisci l’immediatezza).

Esempio di lieve riscrittura

Versione alternativa (mantiene il senso, lavora su ritmo e connessioni)

vedi l’allodola planare
il suo volo un arco immaginario
che lascia nel cielo

l’albero lo riconosci dal frutto
pensi
e ti sorprende quel detto dei Vangeli

il dimenticato aspetta
come pane un sorriso

ti vedrebbe
come un angelo sulla terra
che gli cura la ferita viva

il sorriso è l’inizio
lo sai


Versione 1

vedi l’allodola planare
arco nel cielo
il sorriso è pane

Versione 2

l’albero dal frutto
ti sorprende il detto dei Vangeli
il dimenticato aspetta un sorriso

Versione 3

sorriso — pane per il dimenticato
tu, angelo che cura la ferita

 
Read more...

from 📖Un capitolo al giorno📚

Costruire nel bene

11. Costruire una città impostata sul bene comune esige, dunque, in primo luogo, di edificare sulla roccia della relazione con Dio. Riconoscere che la verità del suo amore ci chiama a una vita «in abbondanza» (Gv 10,10) e alla comunione con Lui. Insieme con sant’Agostino, anche noi possiamo dire: «Ci hai fatti per te, e il nostro cuore non ha posa finché non riposa in te». [8] Dio, infatti, ha inscritto nel nostro cuore un desiderio di felicità che abbraccia tutte le dimensioni della vita, e la Chiesa, nel dialogo con gli uomini e le donne del nostro tempo, avverte l’urgenza di custodire e orientare tale aspirazione verso la sua verità più profonda.

12. In secondo luogo, edificare nel bene significa accettare il limite e la fragilità dell’umanità senza considerarli un errore da correggere. Oggi, il desiderio di pienezza dell’essere umano rischia di essere deviato verso mete ingannevoli: l’illusione di una tecnica che promette di liberarci da ogni fragilità o modelli di benessere che “lasciano indietro” interi popoli. Non di rado, riponiamo la speranza in un potenziamento senza limiti, in forme di progresso che possono esacerbare le disuguaglianze, in soluzioni immediate incapaci di sanare le ferite dei popoli. Così, mentre alcuni inseguono la chimera di un’autoaffermazione illimitata, molti restano privi del necessario. La Chiesa ricorda, con voce umile ma ferma, che la vera realizzazione non nasce dalla rimozione delle fragilità, ma da una crescita armoniosa: là dove libertà e responsabilità si intrecciano con la cura reciproca e la vera solidarietà, e dove il progresso si misura sulla dignità di ciascuno e sul bene dei popoli.

13. Costruire un mondo in cui tutti possono “fiorire” esige, in terzo luogo, una corresponsabilità coraggiosa. Nessuna mano, da sola, è sufficiente a sostenere il peso delle sfide che attraversano il mondo; e nessuna è così debole da non poter offrire il proprio contributo: «La forza infatti si manifesta pienamente nella debolezza» (2Cor 12,9). A ciascuno il suo tratto di muro: scienziati e ricercatori, imprenditori e lavoratori, educatori e legislatori, società civile, movimenti popolari e comunità di fede. Questa è la logica della sussidiarietà, che valorizza la cooperazione tra generazioni, tra popoli, tra discipline e culture come via maestra per far crescere stabilità, prosperità e pace. Le tensioni e le differenze non devono intimorire: possono diventare energie creative quando sono orientate da una responsabilità condivisa.

14. Infine, edificare nel bene domanda un linguaggio evangelico. Evitiamo parole che umiliano o contrappongono. Scegliamo la chiarezza che illumina e la franchezza che apre vie. Non benediciamo entusiasmi ingenui, non alimentiamo paure sterili. Piuttosto, indichiamo criteri di discernimento – dignità della persona, destinazione universale dei beni, opzione per i poveri, cura della Casa comune, pace – e traduciamoli in prassi: progettazione responsabile, valutazioni d’impatto umano e sociale, inclusione dei più fragili, alfabetizzazione digitale, ricerca e industria orientate alla giustizia e alla pace.

=●=●=●=●=●=●=●=●=●=●=●=

Note

[8] S. Agostino, Confessiones, I, 1, 1: CCSL 27, Turnhout 1981, 1.


🔝 ● C A L E N D A R I ● Indice BIBBIA ● Homepage

 
Continua...