Integrazioni Ultralytics
Questa pagina elenca gli strumenti e le piattaforme con cui Ultralytics si integra per supportare i tuoi flussi di lavoro di machine learning, dalla gestione dei dataset e dall'addestramento dei modelli al monitoraggio degli esperimenti e alla distribuzione.
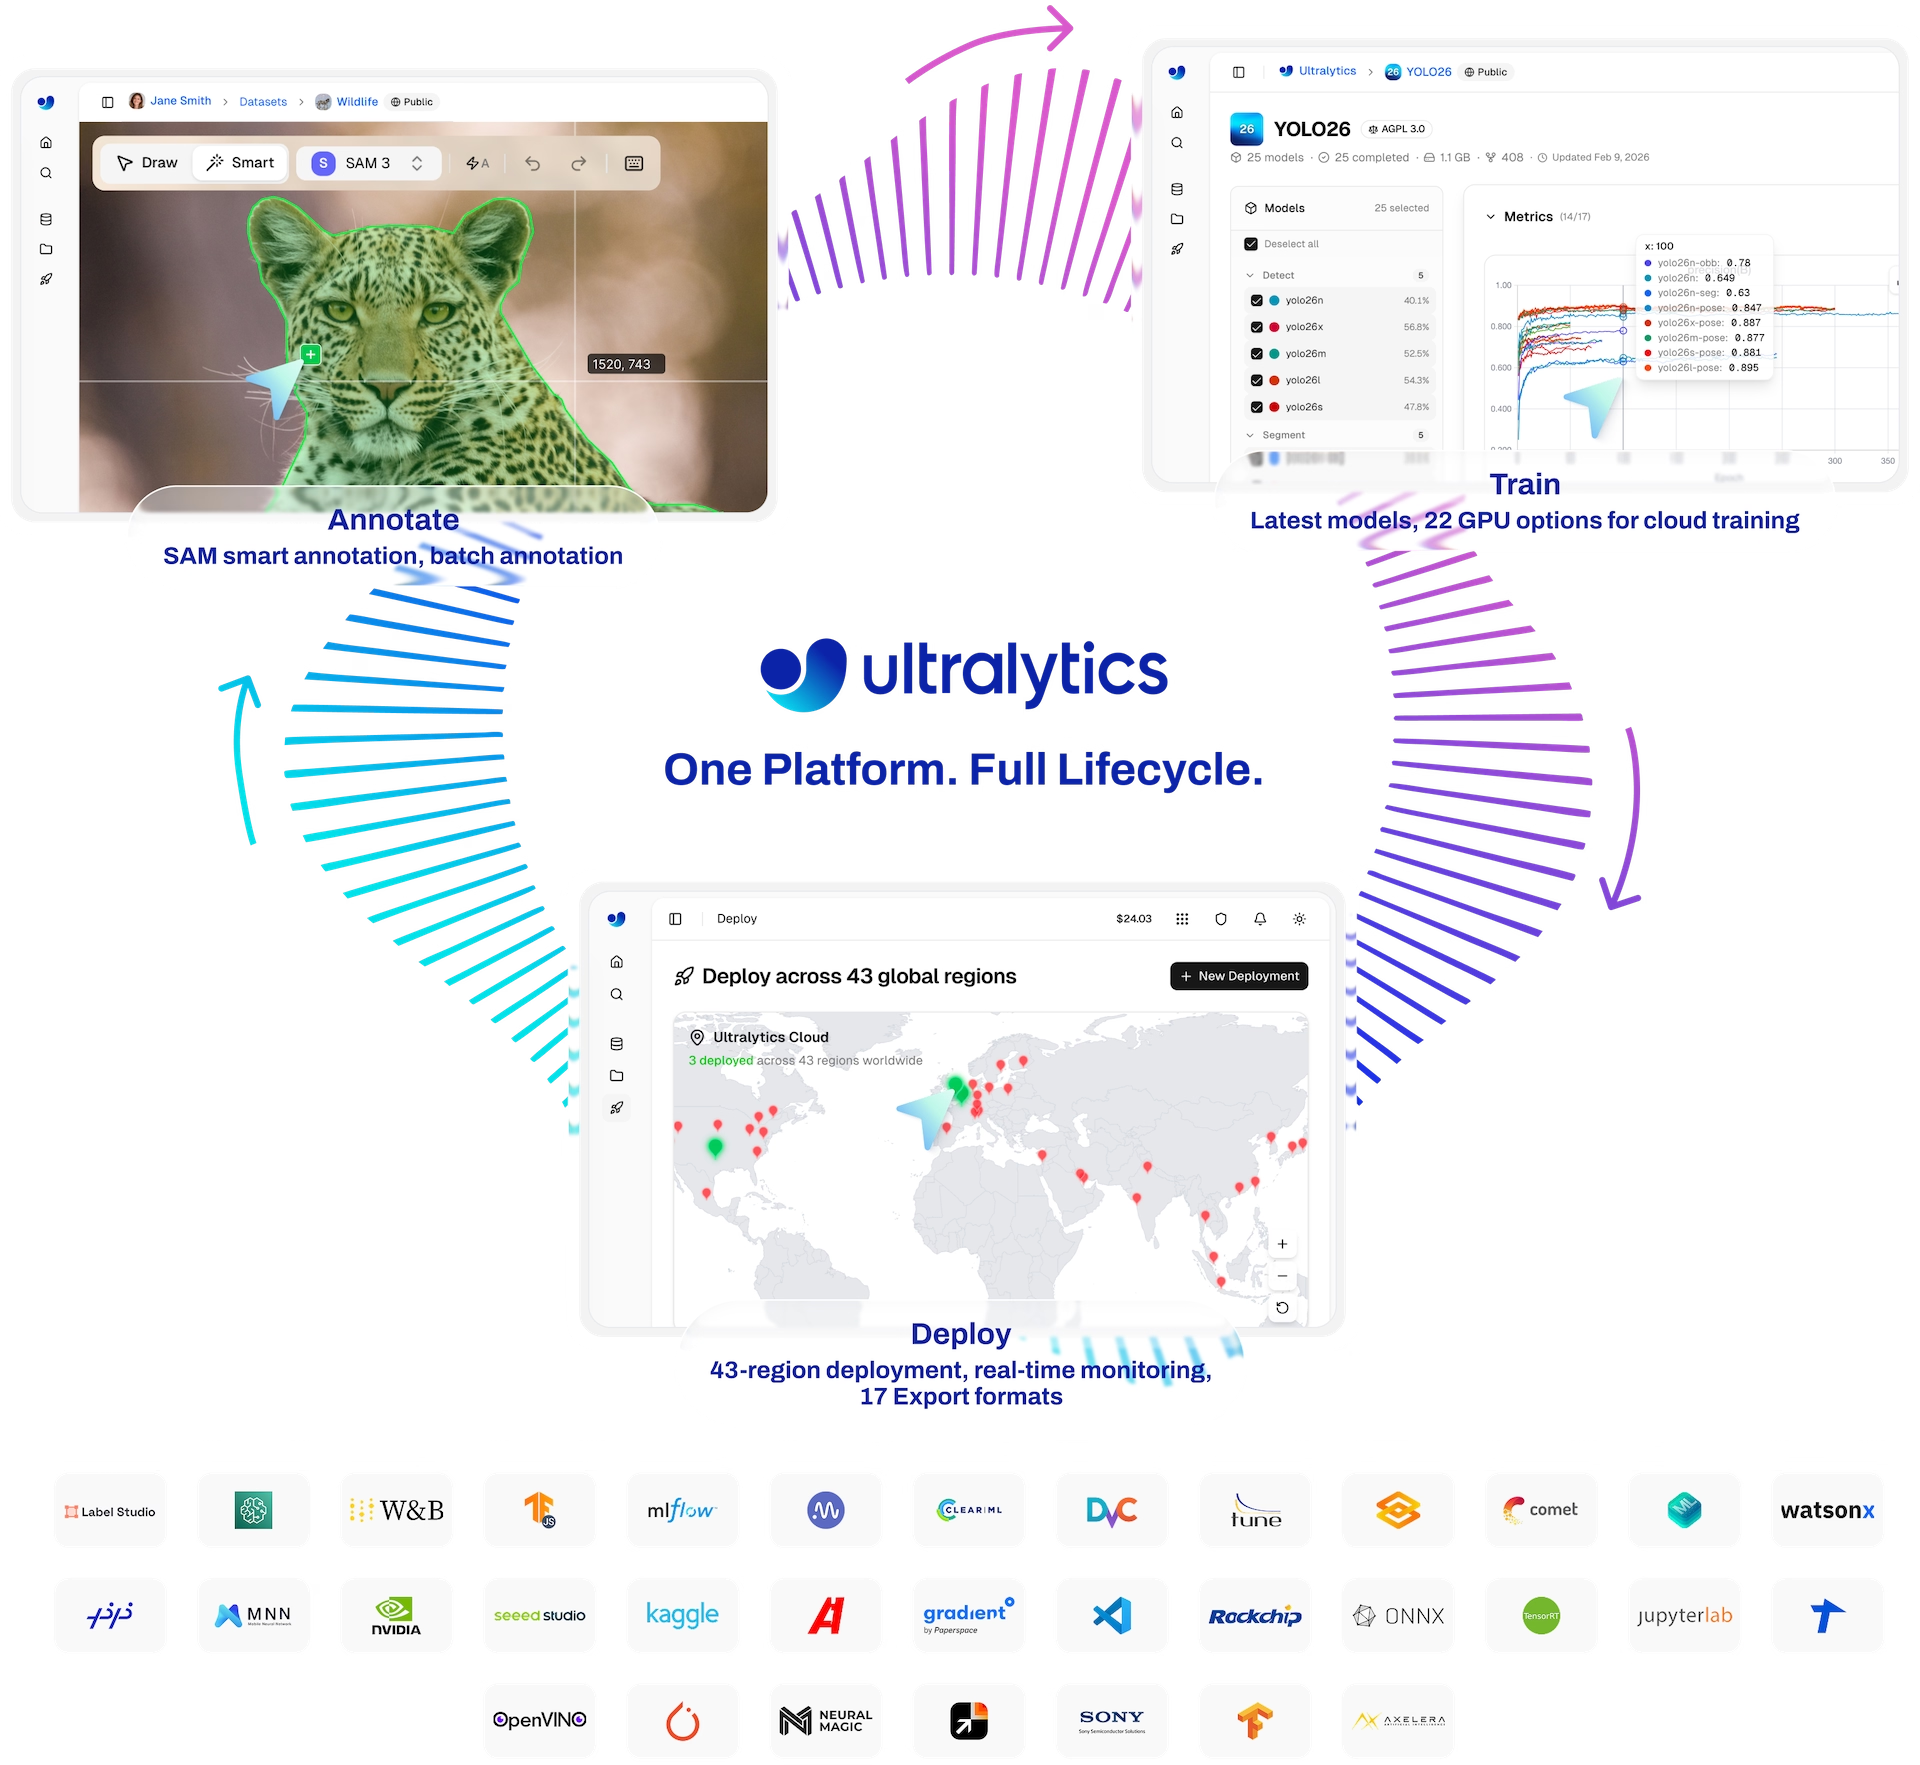
Guarda: Distribuzione e integrazioni di Ultralytics YOLO
Integrazioni per l'addestramento#
-
Agent Skills: insegna agli agenti di programmazione basati sull'IA, come Claude Code, Codex, Cursor e Gemini CLI, l'intero flusso di lavoro Ultralytics YOLO con competenze ufficiali che coprono dataset, addestramento, inferenza ed esportazione.
-
Albumentations: applica ulteriori augmentations alle immagini durante l'addestramento Ultralytics per migliorare la robustezza e la capacità di generalizzazione del modello.
-
Amazon SageMaker: usa Amazon SageMaker per creare, addestrare e distribuire modelli Ultralytics su un'unica piattaforma per l'intero ciclo di vita del machine learning.
-
ClearML: automatizza i tuoi flussi di lavoro di machine learning con Ultralytics, monitora gli esperimenti e collabora con il tuo team.
-
Comet ML: migliora lo sviluppo dei tuoi modelli con Ultralytics monitorando, confrontando e ottimizzando gli esperimenti di apprendimento automatico.
-
DVC: implementa il controllo delle versioni per i tuoi progetti di apprendimento automatico con Ultralytics, sincronizzando dati, codice e modelli in modo efficace.
-
Google Colab: usa Google Colab per addestrare e valutare i modelli Ultralytics in un ambiente cloud che supporta la collaborazione e la condivisione.
-
IBM Watsonx: addestra e valuta i modelli Ultralytics nei notebook IBM watsonx.ai, insieme agli strumenti IBM per la gestione dei dati e la governance dei modelli.
-
JupyterLab: usa l'ambiente interattivo e personalizzabile di JupyterLab per addestrare e valutare i modelli Ultralytics.
-
Kaggle: scopri come usare Kaggle per addestrare e valutare i modelli Ultralytics in un ambiente cloud con librerie preinstallate, supporto GPU e una community attiva con cui collaborare e condividere.
-
MLflow: Semplifica l'intero ciclo di vita ML dei modelli Ultralytics, dalla sperimentazione e riproducibilità fino alla distribuzione.
-
Modal: esegui i modelli Ultralytics sulla piattaforma cloud serverless di Modal, con provisioning automatico delle GPU, tariffazione al secondo e scalabilità automatica per i carichi di lavoro di inferenza e addestramento.
-
Paperspace Gradient: usa le GPU cloud e i notebook di Paperspace Gradient per addestrare, testare e distribuire i modelli YOLO26.
-
Ray Tune: esegui la ricerca degli iperparametri per i tuoi modelli Ultralytics a qualsiasi scala.
-
TensorBoard: visualizza le esecuzioni di addestramento Ultralytics e monitora le metriche del modello.
-
Ultralytics Platform: addestra, gestisci e distribuisci i modelli Ultralytics nel browser e scarica i modelli preaddestrati ufficiali e i dataset.
-
VS Code: un'estensione per VS Code che offre frammenti di codice per accelerare i flussi di lavoro di sviluppo con Ultralytics ed esempi che aiutano chiunque a imparare o iniziare.
-
Weights & Biases (W&B): monitora gli esperimenti, visualizza le metriche e favorisci la riproducibilità e la collaborazione nei progetti Ultralytics.
-
YAML2ModelGraph: genera diagrammi architetturali SVG pronti per la pubblicazione direttamente dai file di configurazione YAML di Ultralytics YOLO.
Integrazioni per la distribuzione#
-
Ambarella: Addestra, comprimi ed esporta i modelli Ultralytics YOLO per i SoC Ambarella CVflow® come il CV72 con il fork Ultralytics di Ambarella, usando l'addestramento consapevole della compressione SpongeTorch e la toolchain CVflow offline.
-
AMD: esporta Ultralytics YOLO in ONNX ed esegui l'inferenza accelerata dalla GPU sulle GPU AMD Instinct e Radeon tramite il provider di esecuzione ONNX Runtime MIGraphX su ROCm; è supportato anche l'addestramento PyTorch ROCm nativo.
-
AMD Xilinx: esporta Ultralytics YOLO con
format="xilinx"per le NPU AMD Versal AI Edge Series Gen 2 usando AMD Quark e Vitis AI; la guida tratta i dispositivi Zynq, Kria e Versal, gli acceleratori DPU e NPU e il supporto degli operatori YOLO. -
Axelera: scopri gli acceleratori Metis e il Voyager SDK per eseguire i modelli Ultralytics con un'inferenza efficiente all'edge.
-
Core AI: scopri il nuovo formato
.aimodeldi Apple, le differenze tra Core AI e Core ML, i limiti attuali e come esportare i modelli YOLO26 conformat="coreai"per la generazione iOS 27 e macOS 27. -
CoreML: CoreML, sviluppato da Apple, è un framework progettato per integrare in modo efficiente i modelli di apprendimento automatico nelle applicazioni per iOS, macOS, watchOS e tvOS, sfruttando l'hardware Apple per una distribuzione dei modelli efficace e sicura.
-
DEEPX: esporta i modelli Ultralytics YOLO nel formato
.dxnndi DEEPX per un'inferenza INT8 a basso consumo energetico sull'hardware NPU DEEPX, destinata ad applicazioni di IA embedded e edge. -
ExecuTorch: sviluppato da Meta, ExecuTorch è la soluzione unificata di PyTorch per distribuire i modelli Ultralytics YOLO sui dispositivi edge.
-
Gradio: distribuisci i modelli Ultralytics con Gradio per creare demo interattive di rilevamento degli oggetti in tempo reale.
-
Hailo: esporta direttamente in Hailo HEF i modelli Ultralytics YOLO per rilevamento, segmentazione, segmentazione semantica, stima della profondità, classificazione, posa e OBB; consulta la guida all'integrazione per i modelli e le piattaforme convalidate.
-
Huawei Ascend: compila i modelli Ultralytics YOLO nel formato offline
.omdi Huawei Ascend con il compilatore CANN ATC, per l'inferenza FP16 sui dispositivi Atlas e OrangePi AIPro. -
LiteRT: sviluppato da Google, LiteRT (in precedenza TensorFlow Lite) è il runtime on-device per il formato
.tflitee consente di distribuire un unico modello su dispositivi mobili, embedded ed edge, oltre che nel browser (tramite LiteRT.js). -
Luxonis OAK: Converti i modelli Ultralytics YOLO con Luxonis Hub o gli strumenti locali Luxonis ed eseguili direttamente sui dispositivi con le telecamere Luxonis OAK
RVC2eRVC4. -
MNN: sviluppato da Alibaba, MNN è un framework leggero di deep learning per l'inferenza e l'addestramento su dispositivi mobili e hardware embedded.
-
NCNN: sviluppato da Tencent, NCNN è un framework di inferenza per reti neurali ottimizzato per i dispositivi mobili. Esegue modelli di IA direttamente nelle app su diverse piattaforme mobili.
-
Neural Magic: Guida storica all'inferenza sparsa su CPU con il motore DeepSparse, le cui librerie della community sono deprecate.
-
NXP: compila modelli YOLO INT8 calibrati per l'NPU Neutron dell'i.MX95 con Neutron SDK 3.3.0.
-
ONNX: un formato open source sviluppato originariamente da Microsoft e Facebook per trasferire modelli di IA tra framework, rendendo i modelli Ultralytics portabili su diversi ambienti di esecuzione e hardware.
-
OpenVINO: il toolkit di Intel per ottimizzare e distribuire modelli di visione artificiale su CPU, GPU e NPU Intel.
-
PaddlePaddle: una piattaforma open source di deep learning sviluppata da Baidu; PaddlePaddle supporta la distribuzione di modelli di IA, con particolare attenzione alle applicazioni industriali scalabili.
-
Qualcomm QNN: compila localmente i modelli Ultralytics YOLO nel formato context-binary di QNN (AI Engine Direct) con il provider di esecuzione QNN di ONNX Runtime, per accelerare l'inferenza su CPU Snapdragon, GPU Adreno e hardware NPU Hexagon nei dispositivi mobili ed edge.
-
Rockchip RKNN: sviluppato da Rockchip, RKNN è un framework di inferenza per reti neurali ottimizzato per le piattaforme hardware Rockchip, in particolare le relative NPU, per l'inferenza IA in tempo reale sui dispositivi edge.
-
Seeed Studio reCamera: sviluppata da Seeed Studio, reCamera è un dispositivo edge AI per applicazioni di visione artificiale in tempo reale. Basata sul processore SG200X con architettura RISC-V, esegue inferenze IA a basso consumo energetico; il design modulare e le funzionalità di elaborazione video la rendono adatta a casi d'uso come il monitoraggio della sicurezza, le applicazioni ambientali e la produzione.
-
SONY IMX500: Ottimizza e distribuisci i modelli Ultralytics YOLOv8n e YOLO11n sulle Raspberry Pi AI Cameras con sensore IMX500 per prestazioni rapide e a basso consumo.
-
TensorRT: sviluppato da NVIDIA, questo framework di inferenza ad alte prestazioni per il deep learning e formato per modelli ottimizza i modelli di IA per velocità ed efficienza sulle GPU NVIDIA.
-
TF GraphDef: sviluppato da Google, GraphDef è il formato di TensorFlow per rappresentare grafi di calcolo e consente di eseguire in modo ottimizzato i modelli di apprendimento automatico su hardware diversi.
-
TF SavedModel: sviluppato da Google, TF SavedModel è un formato di serializzazione per i modelli TensorFlow, che ne consente la condivisione e la distribuzione su un'ampia gamma di piattaforme, dai server ai dispositivi edge.
-
TFLite Edge TPU: sviluppato da Google per ottimizzare i modelli TensorFlow Lite sulle Edge TPU, questo formato per modelli consente un'elaborazione edge rapida ed efficiente.
-
TorchScript: sviluppato nell'ambito del framework PyTorch, TorchScript consente di eseguire e distribuire in modo efficiente i modelli di apprendimento automatico in diversi ambienti di produzione senza dipendenze da Python.
Integrazioni per i dataset#
- Roboflow: semplifica l'etichettatura e la gestione dei dataset per i modelli Ultralytics, offrendo strumenti per annotare le immagini.
Formati di esportazione#
Supportiamo anche vari formati di esportazione dei modelli per la distribuzione in ambienti diversi. Ecco i formati disponibili:
| Formato | Argomento format | Modello | Metadati | Argomenti |
|---|---|---|---|---|
| PyTorch | - | yolo26n.pt | ✅ | - |
| TorchScript | torchscript | yolo26n.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo11n_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
| NXP | nxp | yolo26n_nxp.tflite | ✅ | imgsz, quantize, data, fraction, device |
nms=None restituisce per impostazione predefinita output grezzi per la NMS esterna (YOLO26 mantiene la propria head senza NMS su Axelera). Imposta nms=False per selezionare una head senza NMS disponibile; i formati non supportati usano il proprio percorso di output nativo. Le voci nms qui sopra identificano i formati che possono incorporare la NMS con nms=True.
Consulta i link per saperne di più su ogni integrazione e scoprire come sfruttarla al meglio con Ultralytics. Consulta i dettagli completi di export nella pagina Esportazione.
Contribuisci alle nostre integrazioni#
Accogliamo con piacere guide della community sull'integrazione di Ultralytics YOLO con altre tecnologie, strumenti e piattaforme. Se hai integrato con successo YOLO con un nuovo sistema o hai informazioni utili da condividere, valuta la possibilità di contribuire alla documentazione sulle integrazioni.
Scrivendo una guida o un tutorial, puoi contribuire ad ampliare la nostra documentazione e fornire esempi pratici utili alla community.
Per contribuire, segui le istruzioni nella nostra guida alla contribuzione per inviare una richiesta pull (PR).
Domande frequenti#
Ultralytics Platform è una piattaforma cloud per flussi di lavoro di machine learning end-to-end con modelli Ultralytics. Puoi caricare e annotare dataset, addestrare modelli su GPU cloud, monitorare gli esperimenti e distribuire modelli YOLO senza dover scrivere molto codice. La piattaforma funge da spazio di lavoro centralizzato per l'intera pipeline di machine learning, dalla preparazione dei dati alla distribuzione.
Sì. L'integrazione di MLflow con i modelli Ultralytics ti consente di monitorare gli esperimenti, migliorare la riproducibilità e semplificare l'intero ciclo di vita ML. Le istruzioni dettagliate per configurare questa integrazione sono disponibili nella pagina dedicata all'integrazione di MLflow. Questa integrazione è particolarmente utile per monitorare le metriche del modello, confrontare diverse esecuzioni di addestramento e gestire il flusso di lavoro ML in modo efficiente. MLflow offre una piattaforma centralizzata per registrare parametri, metriche e artefatti, semplificando la comprensione del comportamento del modello e l'introduzione di miglioramenti basati sui dati.
Per distribuire modelli Ultralytics YOLO con Gradio e creare demo interattive di rilevamento di oggetti, puoi seguire i passaggi indicati nella pagina di integrazione di Gradio. Gradio crea interfacce web per l'inferenza dei modelli in tempo reale, utili per mostrare il tuo modello YOLO sia agli sviluppatori sia agli utenti finali. Con poche righe di codice puoi creare applicazioni interattive che illustrano le prestazioni del tuo modello su input personalizzati.


Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
