Ultralytics 集成
本页列出了 Ultralytics 集成的工具和平台,用于支持你的机器学习工作流,涵盖从数据集管理和模型训练到实验跟踪和部署。
观看: Ultralytics YOLO 部署与集成
训练集成#
-
Agent Skills:通过涵盖数据集、训练、推理和导出的官方技能,让 Claude Code、Codex、Cursor 和 Gemini CLI 等 AI 编码代理掌握完整的 Ultralytics YOLO 工作流程。
-
Albumentations:在 Ultralytics 训练期间应用额外的图像增强,以提升模型的鲁棒性和泛化能力。
-
Amazon SageMaker:使用 Amazon SageMaker 在一个平台上构建、训练和部署 Ultralytics 模型,覆盖整个机器学习生命周期。
-
Comet ML:通过跟踪、比较和优化机器学习实验,提升 Ultralytics 模型的开发效率。
-
DVC:为 Ultralytics 机器学习项目实施版本控制,有效同步数据、代码和模型。
-
Google Colab:使用 Google Colab 在支持协作和共享的云环境中训练和评估 Ultralytics 模型。
-
IBM Watsonx:在 IBM watsonx.ai 笔记本中训练和评估 Ultralytics 模型,并配合 IBM 的数据管理和模型治理工具使用。
-
JupyterLab:使用 JupyterLab 的交互式、可自定义环境训练和评估 Ultralytics 模型。
-
Kaggle:了解如何在基于云的环境中使用 Kaggle 训练和评估 Ultralytics 模型。该环境预装了库,支持 GPU,并拥有活跃的社区,便于协作和分享。
-
MLflow:简化 Ultralytics 模型的整个 ML 生命周期,涵盖实验、可复现性和部署。
-
Modal:在 Modal 无服务器云平台上运行 Ultralytics 模型,享受自动配置 GPU、按秒计费,以及针对推理和训练工作负载的自动扩缩容。
-
Paperspace Gradient:使用 Paperspace Gradient 云 GPU 和笔记本训练、测试和部署 YOLO26 模型。
-
TensorBoard:可视化 Ultralytics 训练运行并监控模型指标。
-
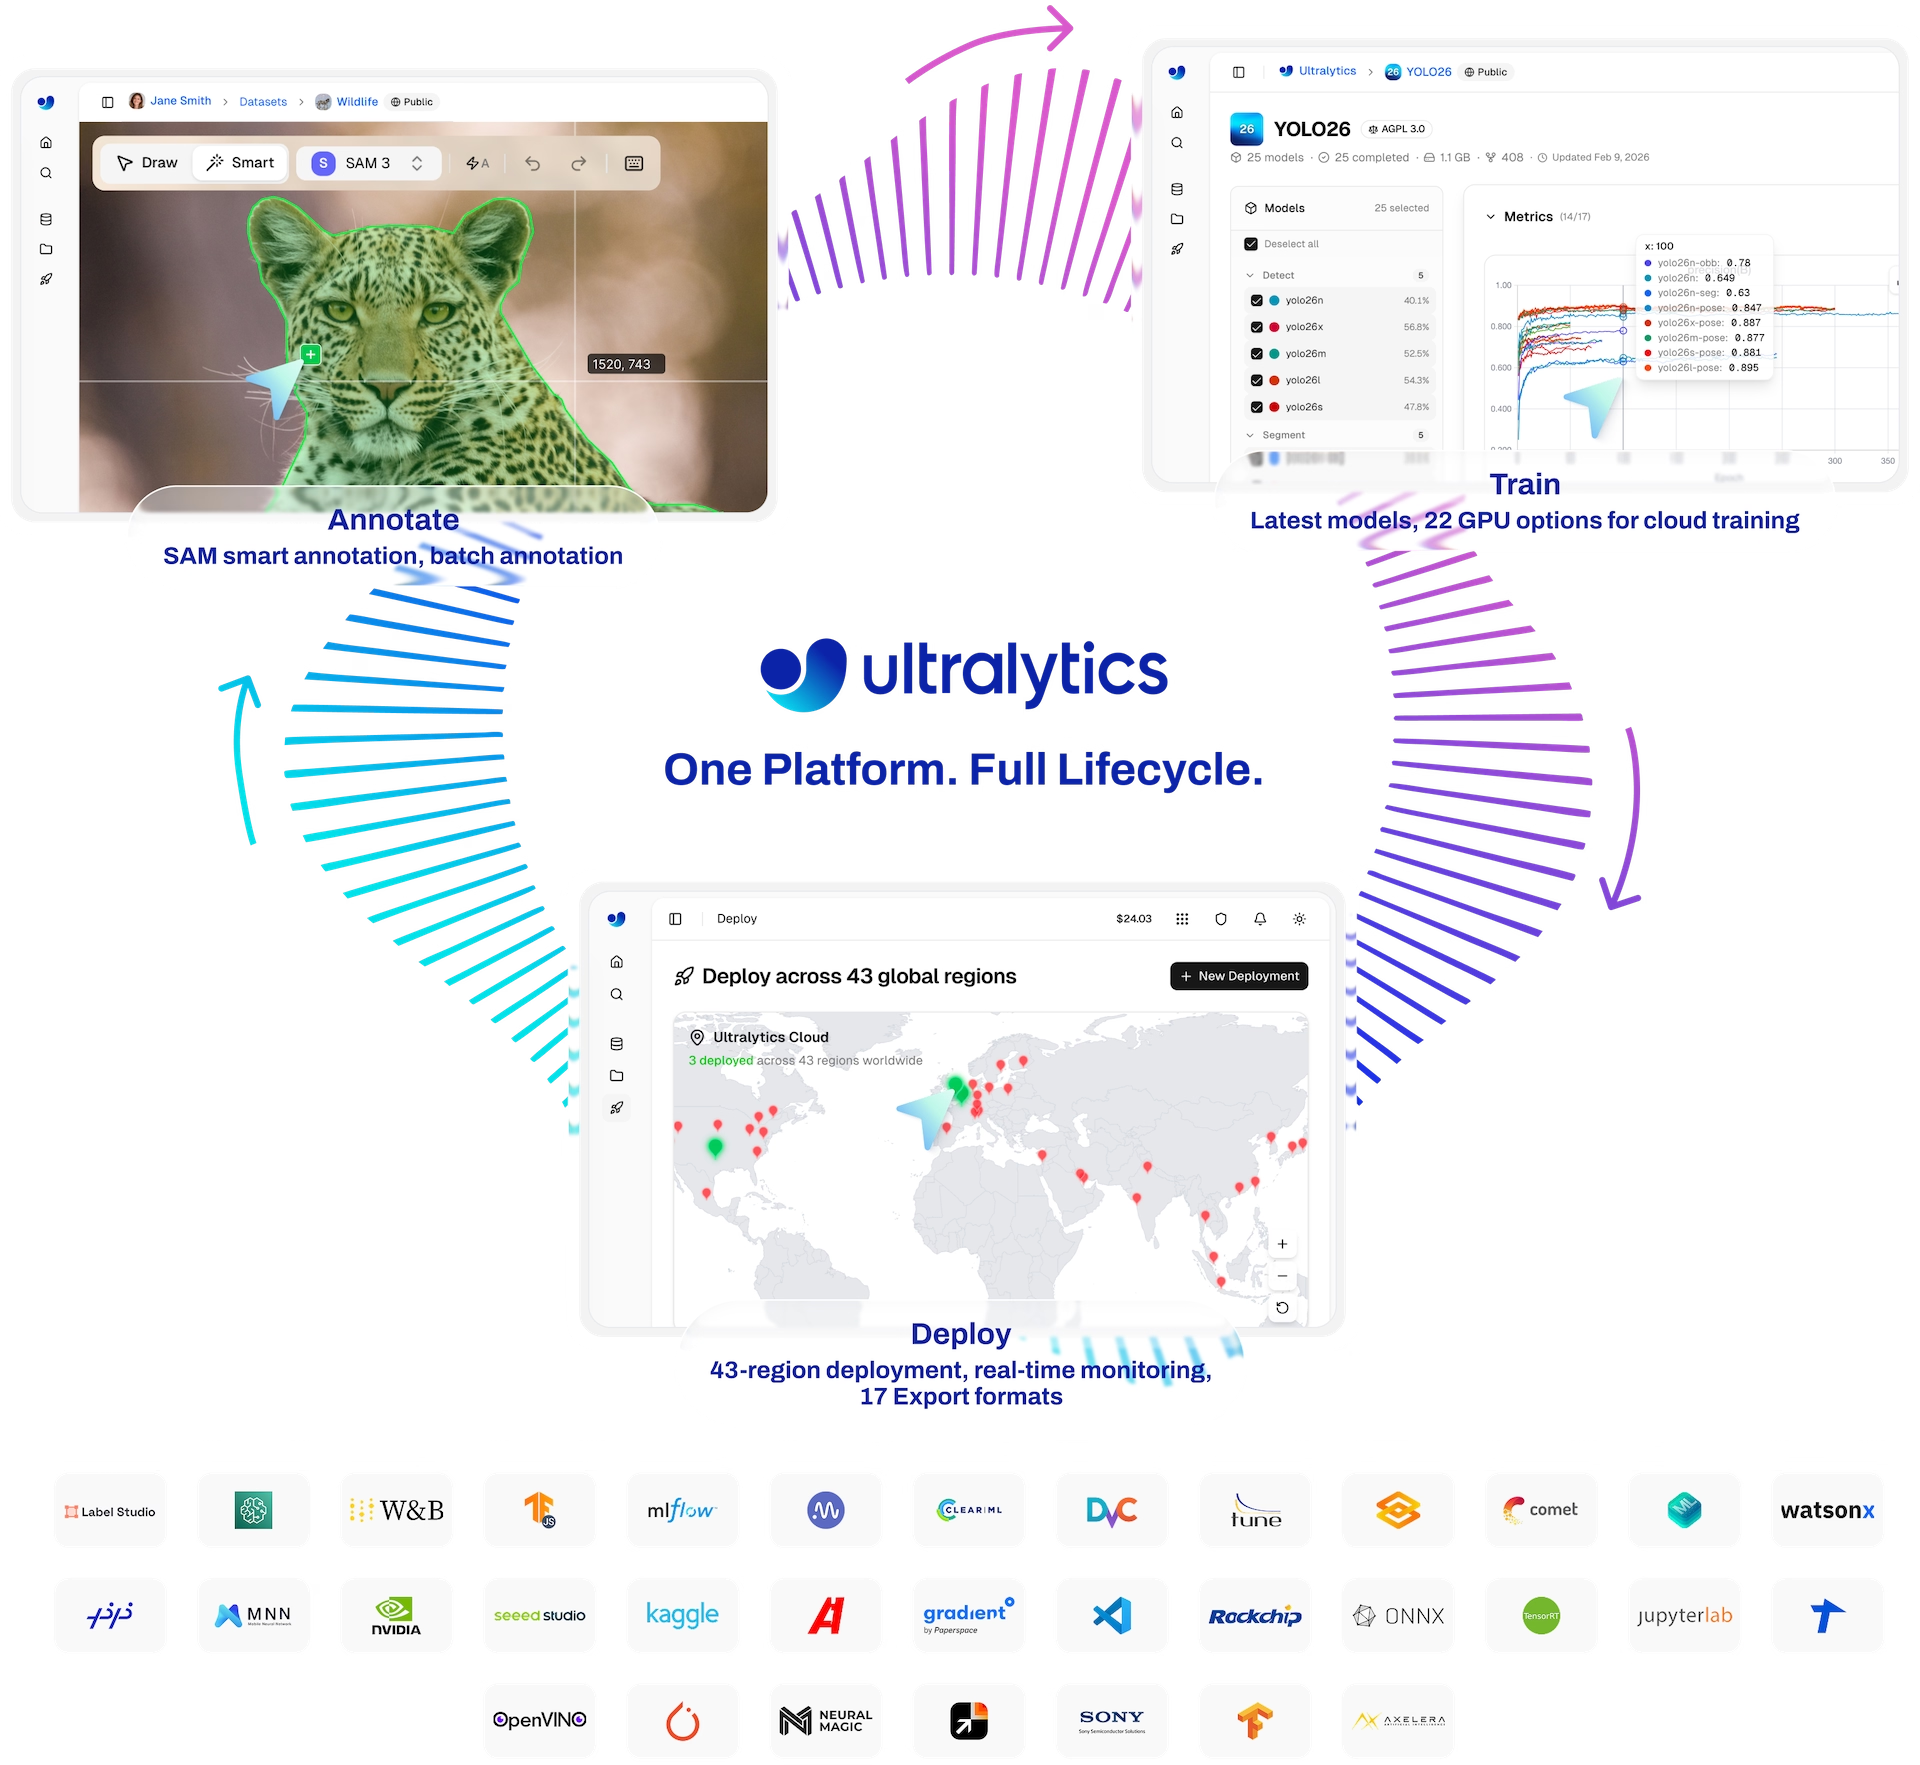
Ultralytics Platform:在浏览器中训练、管理和部署 Ultralytics 模型,并下载官方预训练模型和数据集。
-
VS Code:适用于 VS Code 的扩展,提供代码片段以加快 Ultralytics 开发工作流程,并提供示例,帮助任何人学习或快速上手。
-
Weights & Biases (W&B):监控实验、可视化指标,并促进 Ultralytics 项目的可复现性与协作。
-
YAML2ModelGraph:直接根据 Ultralytics YOLO YAML 配置文件生成适用于出版物的 SVG 架构图。
部署集成#
-
Ambarella:使用 Ambarella 的 Ultralytics 分支,借助 SpongeTorch 感知压缩的训练和离线 CVflow 工具链,为 CV72 等 Ambarella CVflow® SoC 训练、压缩和导出 Ultralytics YOLO 模型。
-
AMD:将 Ultralytics YOLO 导出为 ONNX,并通过 ROCm 上的 ONNX Runtime MIGraphX 执行提供程序,在 AMD Instinct 和 Radeon GPU 上运行 GPU 加速推理;同时也支持原生 PyTorch ROCm 训练。
-
AMD Xilinx:使用
format="xilinx"导出 Ultralytics YOLO,以用于 AMD Versal AI Edge Series Gen 2 NPU,并借助 AMD Quark 和 Vitis AI;本指南还介绍 Zynq、Kria 和 Versal 设备、DPU 与 NPU 加速器的区别,以及 YOLO 算子支持情况。 -
Axelera:了解 Metis 加速器和 Voyager SDK,使用高效的边缘推理运行 Ultralytics 模型。
-
Core AI:了解 Apple 全新的
.aimodel格式、Core AI 与 Core ML 的对比及其当前限制,以及如何使用format="coreai"导出适用于 iOS 27 和 macOS 27 新一代系统的 YOLO26 模型。 -
CoreML:CoreML 由 Apple 开发,是一个框架,旨在利用 Apple 硬件,高效地将机器学习模型集成到 iOS、macOS、watchOS 和 tvOS 应用中,实现安全有效的模型部署。
-
DEEPX:将 Ultralytics YOLO 模型导出为 DEEPX
.dxnn格式,以便在 DEEPX NPU 硬件上进行节能的 INT8 推理,适用于嵌入式和边缘 AI 应用。 -
ExecuTorch:由 Meta 开发的 ExecuTorch 是 PyTorch 提供的统一解决方案,可将 Ultralytics YOLO 模型部署到边缘设备上。
-
Gradio:使用 Gradio 部署 Ultralytics 模型,构建实时交互式目标检测演示。
-
Hailo:将 Ultralytics YOLO 检测、分割、语义分割、深度估计、分类、姿态和 OBB 模型直接导出为 Hailo HEF;有关已验证的模型和目标设备,请参阅集成指南。
-
Huawei Ascend:使用 CANN ATC 编译器,将 Ultralytics YOLO 模型编译为 Huawei Ascend
.om离线格式,以便在 Atlas 和 OrangePi AIPro 设备上进行 FP16 推理。 -
LiteRT:LiteRT 由 Google 开发,原名 TensorFlow Lite,是适用于设备端
.tflite格式的运行时,可将单个模型部署到移动设备、嵌入式设备、边缘设备和浏览器(通过 LiteRT.js)。 -
Luxonis OAK:使用 Luxonis Hub 或本地 Luxonis 工具转换 Ultralytics YOLO 模型,并在 Luxonis OAK
RVC2和RVC4摄像头上运行模型。 -
NCNN:NCNN 由腾讯开发,是一个针对移动设备优化的神经网络推理框架。它可在各种移动平台的应用中直接运行 AI 模型。
-
Neural Magic:关于使用 DeepSparse 引擎进行稀疏 CPU 推理的历史指南;该引擎的社区库现已弃用。
-
NXP:使用 Neutron SDK 3.3.0,为 i.MX95 Neutron NPU 编译经过校准的 INT8 YOLO 模型。
-
ONNX:一种最初由微软和 Facebook 开发的开源格式,用于在框架之间传输 AI 模型,让 Ultralytics 模型能够在不同运行时和硬件上运行。
-
PaddlePaddle:由百度开发的开源深度学习平台,专注于可扩展的工业应用,支持 AI 模型部署。
-
Qualcomm QNN:使用 ONNX Runtime QNN 执行提供程序,在本地将 Ultralytics YOLO 模型编译为 QNN (AI Engine Direct) context-binary 格式,从而在移动设备和边缘设备的 Snapdragon CPU、Adreno GPU 和 Hexagon NPU 硬件上加速推理。
-
Rockchip RKNN:RKNN 由瑞芯微开发,是一个针对瑞芯微硬件平台(尤其是其 NPU)优化的神经网络推理框架,可在边缘设备上实现实时 AI 推理。
-
Seeed Studio reCamera:reCamera 由矽递科技开发,是一款用于实时计算机视觉应用的边缘 AI 设备。它由基于 RISC-V 的 SG200X 处理器驱动,可高效运行 AI 推理;其模块化设计和视频处理能力适用于安全监控、环境应用和制造等场景。
-
SONY IMX500:针对搭载 IMX500 传感器的 Raspberry Pi AI Cameras 优化并部署 Ultralytics YOLOv8n 和 YOLO11n 模型,实现快速、低功耗的性能。
-
TensorRT:该高性能深度学习推理框架和模型格式由 NVIDIA开发,可针对 NVIDIA GPU 优化 AI 模型的速度和效率。
-
TF GraphDef:GraphDef 由 Google 开发,是 TensorFlow 用于表示计算图的格式,可在各种硬件上优化机器学习模型的执行。
-
TF SavedModel:TF SavedModel 由 Google开发,是一种用于序列化TensorFlow模型的格式,可在从服务器到边缘设备的各种平台上共享和部署模型。
-
TFLite Edge TPU:该模型格式由 Google开发,用于在 Edge TPU 上优化 TensorFlow Lite 模型,可实现快速、高效的边缘计算。
-
TorchScript:TorchScript 作为 PyTorch 框架的一部分开发,无需依赖 Python,即可在各种生产环境中高效执行和部署机器学习模型。
数据集集成#
- Roboflow:为 Ultralytics 模型提供数据集标注和管理支持,并提供图像标注工具。
导出格式#
我们还支持多种模型导出格式,以便在不同环境中部署。以下是可用格式:
| 格式 | format 参数 | 模型 | 元数据 | 参数 |
|---|---|---|---|---|
| PyTorch | - | yolo26n.pt | ✅ | - |
| TorchScript | torchscript | yolo26n.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo11n_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
| NXP | nxp | yolo26n_nxp.tflite | ✅ | imgsz, quantize, data, fraction, device |
nms=None 默认输出原始结果,以便进行外部 NMS(YOLO26 在 Axelera 上保留其无 NMS 检测头)。设置 nms=False 以选择可用的无 NMS 检测头;不支持的格式会回退到其原生输出路径。上方的 nms 条目指出可通过 nms=True 嵌入 NMS 的格式。
点击链接,了解各项集成的更多信息,以及如何充分利用这些集成功能来配合 Ultralytics 使用。请参阅 导出页面,了解完整的 export 详情。
为我们的集成项目贡献力量#
我们欢迎社区贡献将 Ultralytics YOLO 与其他技术、工具和平台集成的指南。如果你已成功将 YOLO 集成到新系统,或有值得分享的见解,可以考虑为我们的集成文档做出贡献。
撰写指南或教程,可以帮助扩展我们的文档,并提供让社区受益的真实案例。
如需贡献内容,请按照贡献指南中的说明提交拉取请求 (PR)。
常见问题#
Ultralytics Platform 是一个基于云的平台,支持使用 Ultralytics 模型开展端到端机器学习工作流。你可以上传和标注数据集、在云 GPU 上训练模型、跟踪实验,以及部署 YOLO 模型,无需编写大量代码。该平台是整个机器学习流水线的集中式工作空间,覆盖从数据准备到部署的各个环节。


评论
提出问题、分享结果,或帮助其他人。
