Cosa succede quando i wikimediani incontrano i maker? È quello che abbiamo scoperto durante la terza edizione dell’hackathon italiano di Wikimedia, che abbiamo organizzato a Messina, in Sicilia.

Il nostro hackathon locale è un modo per riunire e rafforzare la comunità tecnica di lingua italiana, per coinvolgere nuovi volontari e per offrire uno spazio in cui incontrarsi, imparare gli uni dagli altri e lavorare alla risoluzione di problemi specifici che abbiamo nei progetti Wikimedia in lingua italiana.

Quest’anno abbiamo aggiunto una nuova dimensione all’evento: abbiamo collaborato con il FabLab Messina, un’associazione che offre accesso ad attrezzature hardware e competenze tecniche. Abbiamo riunito 20 persone, tra wikimediani esperti e neofiti, con una sfida: collaborare per 3 giorni per correggere bug o creare qualcosa di nuovo.
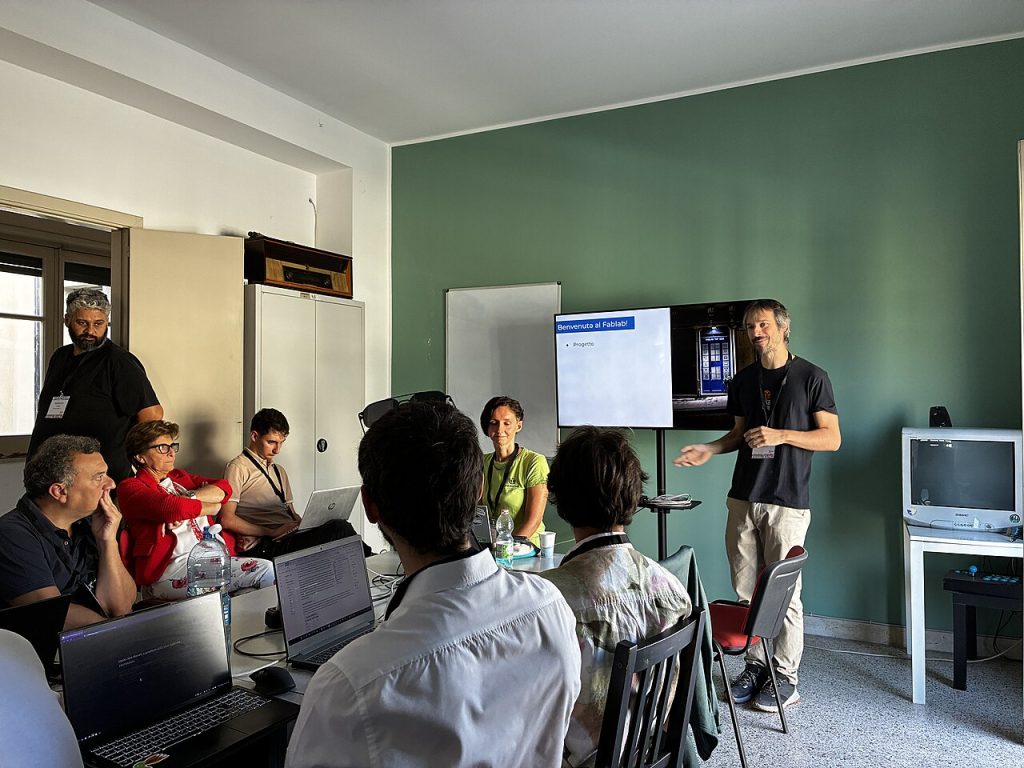
Image
Sessione di introduzione dell’Hackathon Messina 2026 di Veniamainblu, CC BY-SA 4.0, via Wikimedia Commons

È meraviglioso vedere la magia che si crea in una stanza, quando persone che due minuti prima non si conoscevano iniziano a parlare con entusiasmo di ciò che potrebbero realizzare insieme.

I progetti dell’hackathon Wikimedia a Messina

Tra i progetti sviluppati durante il fine settimana, possiamo citare:

  • Un dispositivo tascabile, low-tech, senza algoritmi né distrazioni, che segnala i punti di interesse nelle vicinanze e mostra la voce di Wikipedia corrispondente. Il prototipo è stato creato da tre studenti entusiasti, supportati da un gruppo di persone che hanno condiviso la propria esperienza con loro.

Questo progetto ha rappresentato perfettamente il tema che avevamo assegnato al nostro evento: “come creare nuovi modi per accedere alla conoscenza, utilizzando tecnologie libere, minimaliste e resilienti?”

Gli stessi studenti hanno anche creato un gioco a quiz simile a Duolingo che attinge informazioni da Wikipedia per presentarle in modo ludico.

  • Open Sound Map: pensate a “Listen to Wikipedia”, ma per OSM. Un sito web che mostra in tempo reale le modifiche apportate a OpenStreetMap su una mappa e riproduce un suono, creando un paesaggio sonoro collaborativo.
  • Importazione dei numeri civici e dei lampioni su OpenStreetMap, a seguito della pubblicazione di un database open data da parte del Comune di Messina.
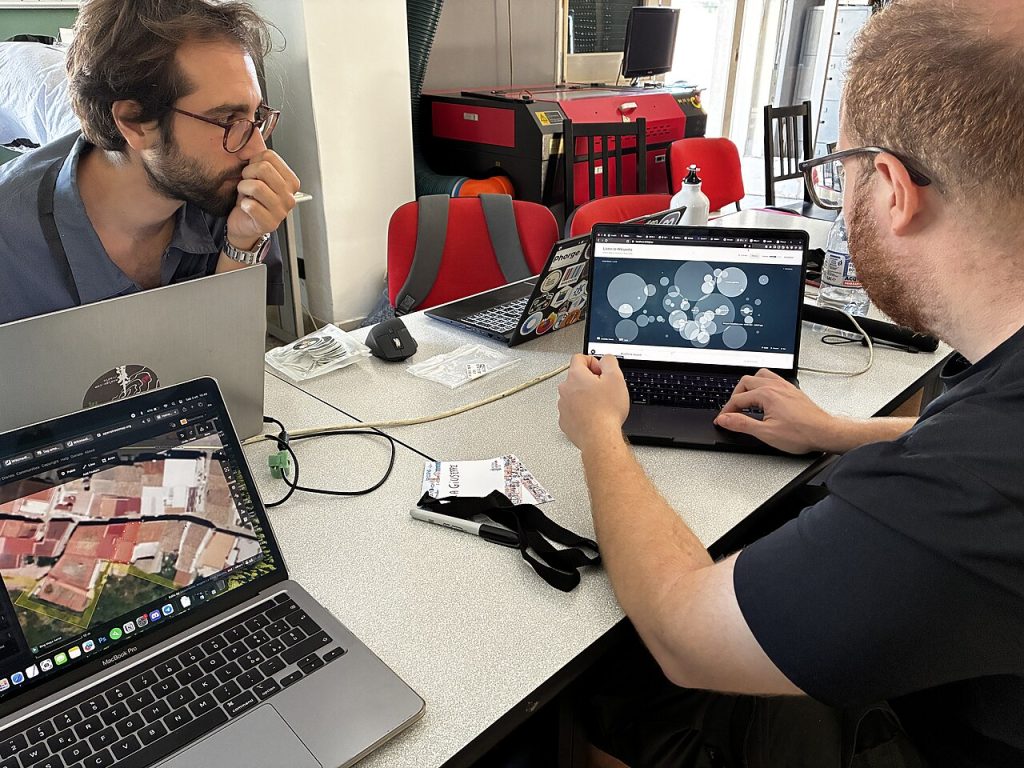
Image
Partecipanti all’ hackathon Wikimedia in Messina in 2026 di Veniamainblu, CC BY-SA 4.0, via Wikimedia Commons

Dato che il Fablab aveva a disposizione l’attrezzatura per stampare su tessuto, abbiamo deciso di fabbricare noi i nostri gadget. È stata una vera avventura stampare, tagliare e rifinire il logo dell’evento, per poi stamparlo su magliette e borse riciclate. Un’esperienza gioiosa per i partecipanti, che se ne sono andati con articoli personalizzati e quel senso di soddisfazione del “l’ho fatto io” che solo l’artigianato sa dare.
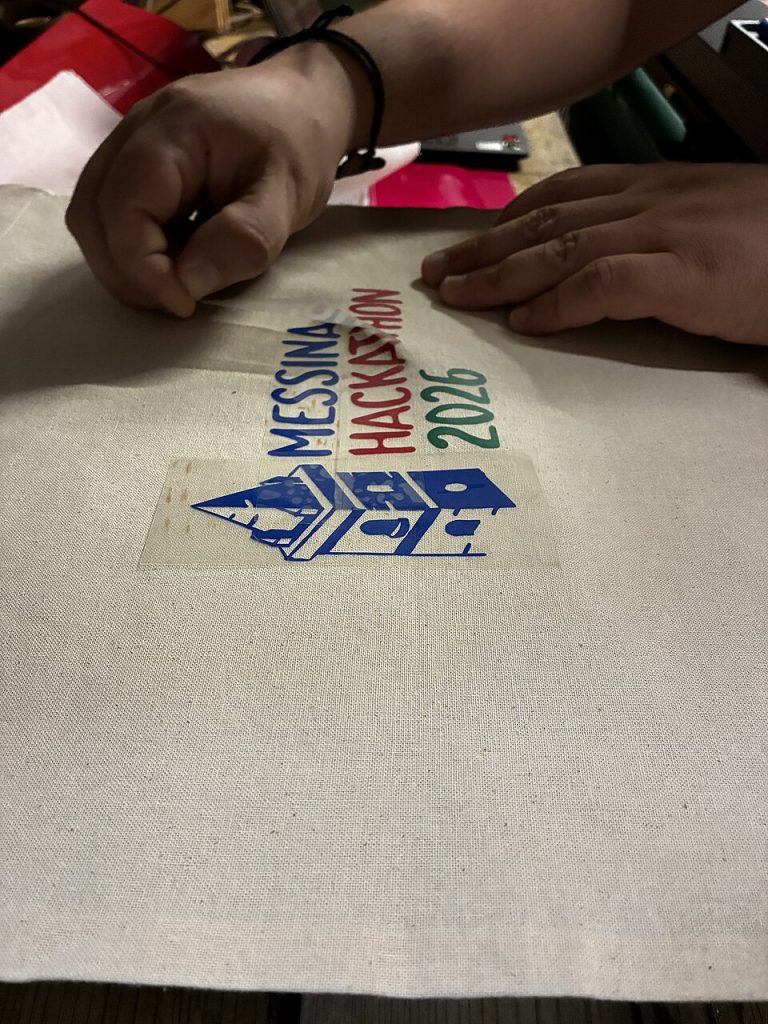
Image
Stampa gadget durante l’hackathon Wikimedia Messina 2026 11 Veniamainblu, CC BY-SA 4.0, via Wikimedia Commons

Mille grazie al Fablab, a Wikimedia Italia che ha finanziato l’evento, ai wikimediani in Sicilia che hanno aiutato ad organizzare l’evento e a tutti i partecipanti per il vostro entusiasmo!

Maggiori informazioni sulla pagina dell’evento con l’elenco dei progetti sviluppati e le foto nella categoria Commons.

Articolo redatto da Veniamainblu e Auregann del gruppo dei Wikimediani in Sicilia

Immagine in evidenza: Wikimedia Hackathon in Messina 2026 di Paolo Piccinini, CC BY-SA 4.0, da Wikimedia Commons
Si avvicina itWikiCon 2026, il convegno annuale della comunità Wikimedia di lingua italiana, che si terrà da venerdì 6 a domenica 8 novembre a Vezia, vicino Lugano, in Svizzera.

Le iscrizioni sono aperte fino a lunedì 12 ottobre a mezzanotte. Per partecipare è necessario compilare il modulo di iscrizione e versare online la quota di partecipazione di 15 CHF, destinata a sostenere l’organizzazione dell’evento.

Clicca qui per iscriverti a itWikiCon 2026

Il programma, tra workshop e unconference

Il programma di itWikiCon 2026 è in costruzione, ma sono già diversi gli appuntamenti definiti. Le sessioni sono organizzate in diversi formati, tra cui workshop e unconference che permettono di alternare momenti di approfondimento a occasioni di confronto e discussione con la comunità.

Tra gli interventi già presenti nel programma, venerdì 6 novembre è prevista l’unconference “Nuovi strumenti di Wikimedia Italia a supporto della comunità”, a cura di Francesca Pinto e Dario Crespi dello staff di Wikimedia Italia. La sessione presenterà alcuni nuovi strumenti introdotti da Wikimedia Italia nel 2026, tra cui uno sportello di supporto legale, accompagnato da FAQ per i casi più comuni, e uno sportello di counseling.

Sabato 7 novembre il programma propone diversi appuntamenti su temi molto attuali per la comunità, tra cui l’unconference “AI is the new copyviol”, a cura di Mastrocom, affronterà il problema dei contenuti generati dai chatbot che possono essere inseriti nelle voci di Wikipedia in violazione delle regole sul copyright. La discussione partirà dall’esperienza dei patroller per ragionare anche sulla possibilità di sviluppare strumenti capaci di individuare automaticamente i testi generati dall’intelligenza artificiale.

A seguire, il Workshop “Quindici anni di Wiki Loves Monuments Italia: quale futuro per il concorso?”, con Ferdinando Traversa, presidente di Wikimedia Italia, proporrà invece una riflessione sull’evoluzione di Wiki Loves Monuments e sulle possibili modalità per innovare la campagna e continuare a documentare il patrimonio culturale italiano.

Sarà poi la volta del workshop “Bando Musei Archivi Biblioteche: dall’idea alla proposta”, condotto da Marta Arosio dello staff di Wikimedia Italia. L’incontro sarà dedicato al bando MAB di Wikimedia Italia e accompagnerà i partecipanti nel passaggio dall’idea iniziale alla progettazione concreta di una proposta, anche attraverso esempi e un’attività pratica.

Contemporaneamente, nell’ambito delle unconference, “Imparare mappando: AvoMappers tra scuola, ambiente, territorio, cittadinanza e open data”, con Alfonso Carlone, racconterà l’esperienza dell’IIS Avogadro di Torino nell’uso di OpenStreetMap, delle tecnologie GIS e dell’informatica come strumenti didattici e di cittadinanza attiva.

Seguiranno Marco Chemello (staff Wikimedia Italia) e Superchilum che proporranno “Vuoi collaborare con un’università o una scuola? Ecco qualche consiglio”, una sessione dedicata a chi vuole avviare collaborazioni tra i progetti Wikimedia e il mondo della didattica. L’incontro affronterà i principali passi da seguire, le pratiche da tenere presenti e gli errori da evitare.

L’unconference “Un tour attraverso le wiki regionali”, con CristianNX, porterà invece lo sguardo oltre l’Italia. Prendendo spunto dalle esperienze presentate alla WikiCon della comunità di lingua tedesca, la sessione presenterà alcuni casi di wiki locali sviluppatesi in Germania, Austria, Francia e Spagna, discutendone potenzialità, limiti e differenze rispetto alle comunità dei progetti Wikimedia in Italia.

Nel pomeriggio, sarà invece il momento di “Note condivise: idee per lavorare con contenuti musicali”, con Marta Arosio. La sessione presenterà l’iniziativa “Note condivise”, che coinvolge quattro istituzioni culturali musicali italiane nella condivisione del loro patrimonio sui progetti Wikimedia, per poi discutere insieme possibili modalità di valorizzazione e riuso dei contenuti.

Ancora nel pomeriggio, si terrà il workshop “#occupyitWikiCon”, con Jaqen, guarderà al futuro di itWikiCon. A quasi dieci anni dalla prima edizione, la sessione propone di confrontare le diverse edizioni del convegno, individuandone punti di forza e aspetti da migliorare, e di lavorare anche agli strumenti e alle indicazioni utili per i futuri organizzatori.

Il workshop “Simulazione di gestione di un caso di conflitto e riflessioni sulla governance dei progetti”, con Civvì, proporrà una simulazione di un caso di conflitto all’interno di un progetto Wikimedia. I partecipanti saranno coinvolti nell’analisi del caso e nella ricerca di possibili soluzioni, per arrivare infine a una riflessione condivisa sulla governance dei progetti.

Questi sono solo alcuni degli appuntamenti già definiti: il programma è ancora in fase di aggiornamento e si arricchirà presto di nuove sessioni e contenuti.

La pagina del programma su Meta-Wiki è il riferimento per chi vuole rimanere aggiornato sul programma.

Tra gli appuntamenti dell’edizione 2026 ci sarà inoltre la tradizionale consegna dei WikiRicci, il premio che, a partire dal 2018, viene assegnato in occasione di itWikiCon ai wikimediani che si sono particolarmente distinti in un particolare ambito.

Una visita al Centro di Calcolo di Lugano

Per la mattina di venerdì 6 novembre è prevista anche una visita guidata al Centro Svizzero di Calcolo Scientifico di Lugano. La visita è aperta ai partecipanti di itWikiCon, previa iscrizione tramite il modulo dell’evento.

Chi intende partecipare al convegno è invitato a organizzare per tempo il proprio viaggio e il pernottamento. Sulla pagina di informazioni di itWikiCon sono disponibili indicazioni e consigli su come raggiungere Vezia e sulle possibilità di alloggio.

Tutte le informazioni aggiornate sull’evento, comprese quelle relative al programma, sono raccolte sulla pagina di itWikiCon 2026 su Meta-Wiki.

Clicca qui per visualizzare la pagina dell’evento

Per domande, proposte o richieste è possibile partecipare alla discussione sulla pagina di discussione dell’evento oppure scrivere all’organizzazione all’indirizzo info@itwikicon.org.

Immagine in evidenza: ItWikiCon 2026 logo horizontal di Maloulou.ch, Pubblico dominio, da Wikimedia Commons

Paesaggi, montagne, laghi, coste e animali: sono gli splendidi protagonisti delle dieci immagini vincitrici di Wiki Loves Earth Italy 2026, la nona edizione nazionale del concorso fotografico internazionale Wiki Loves Earth, dedicato alle aree protette del patrimonio naturale e alla biodiversità del nostro Paese.

Che cos’è Wiki Loves Earth Italy

Wiki Loves Earth Italy è il concorso che invita fotografi e appassionati a documentare le aree naturali protette, i monumenti naturali e gli ambienti che custodiscono la ricchezza del territorio italiano. Le fotografie vengono caricate su Wikimedia Commons, l’archivio digitale che raccoglie immagini e altri contenuti multimediali, rilasciati con licenze libere, collegate ai vari progetti Wikimedia, con l’obiettivo di rendere questo patrimonio visibile e riutilizzabile da tutti.

L’edizione italiana 2026 ha raccolto 1.312 fotografie. Le immagini sono state valutate in due categorie: Paesaggi, che comprende anche gli alberi monumentali, e Macro e primi piani di animali, piante e funghi. Per ciascuna categoria sono state selezionate cinque fotografie vincitrici, che hanno avuto accesso alla fase internazionale del concorso.

Clicca qui per visualizzare tutte le fotografie di Wiki Loves Earth Italy 2026

Le foto vincitrici della categoria Paesaggi

Le cinque immagini selezionate nella categoria Paesaggi attraversano alcuni degli scenari naturali più suggestivi d’Italia, dalle Alpi alla costa pugliese, fino alle Dolomiti e all’Appennino.

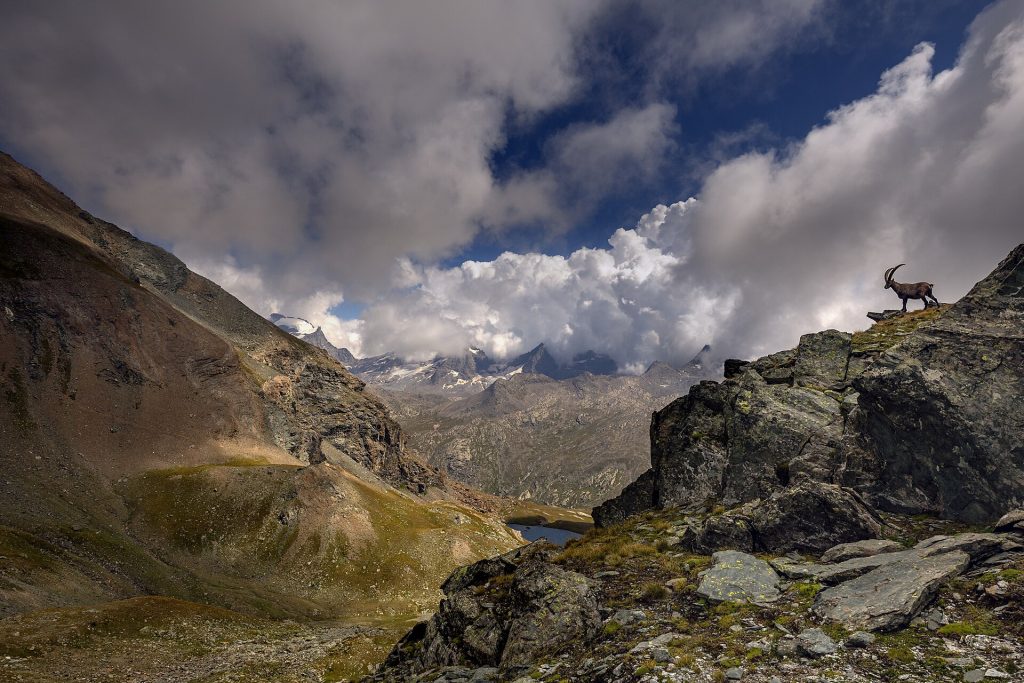
1. La vedetta del Parco nazionale del Gran Paradiso

Image
La vedetta del Parco Nazionale del Gran Paradiso di LucaCasale1961, CC BY-SA 4.0, da Wikimedia Commons

Uno stambecco sembra fare la guardia alle cime del Parco nazionale del Gran Paradiso, in uno scatto che mette insieme la presenza della fauna selvatica e l’imponenza dell’ambiente alpino.

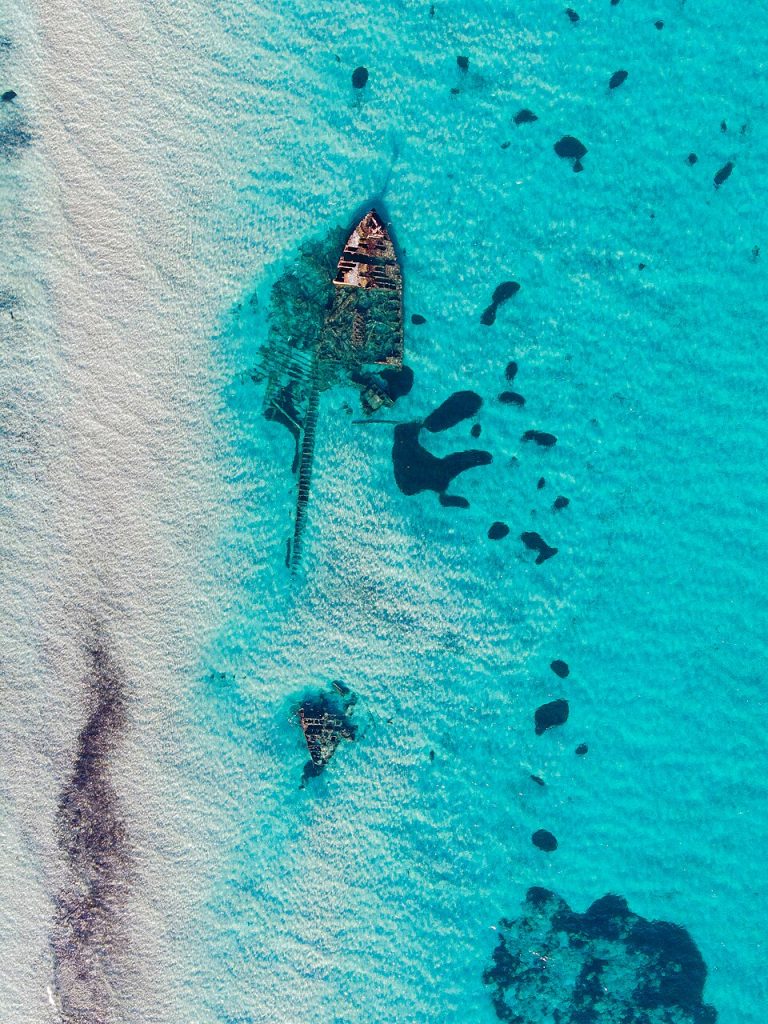
2. Il relitto della nave Dimitrios

Image
Alimini – Il Relitto di Nave “Dimitrios” di Raffaele Martano, CC BY-SA 4.0, da Wikimedia Commons

Nel 1978 la nave Dimitrios naufragò lungo il litorale degli Alimini, a Otranto. Rimasto per molti anni a pochi metri dalla riva, il relitto è oggi quasi completamente scomparso nelle acque. La fotografia ne conserva la memoria e racconta il rapporto tra storia, mare e paesaggio costiero.

3. Grotta della Poesia

Image
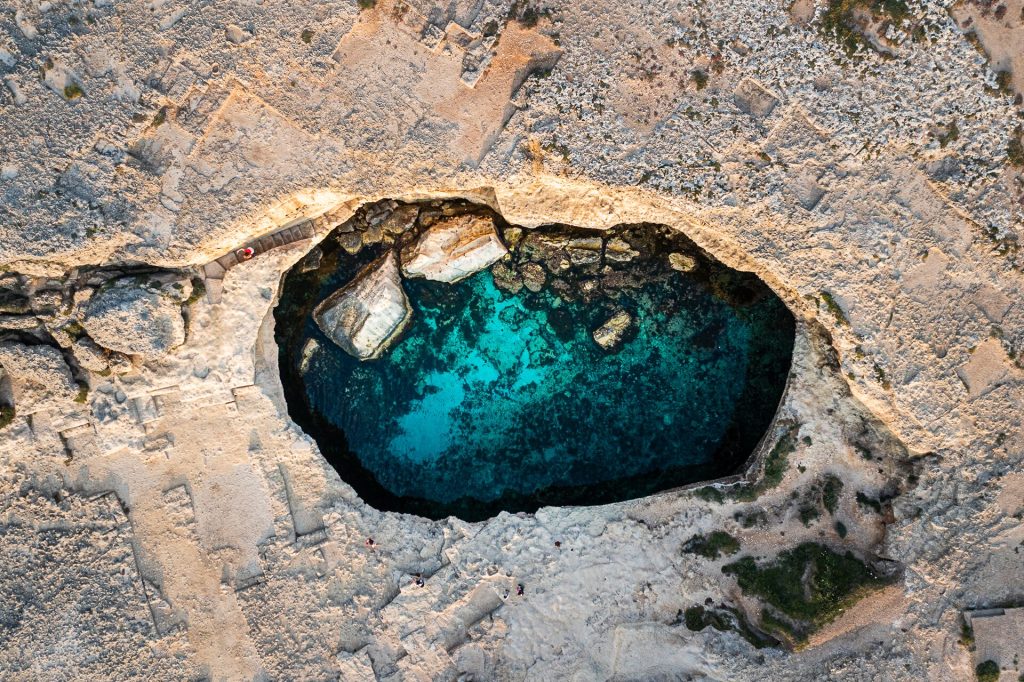
Otranto torre dell’orso grotta della poesia di Pakycassano, CC BY-SA 4.0, da Wikimedia Commons

La Grotta della Poesia, lungo la costa tra Otranto e Santa Maria di Leuca, è protagonista di una fotografia che restituisce la particolare conformazione della costa salentina e delle sue acque.

4. Riflesso invernale al lago di Fusine

Image
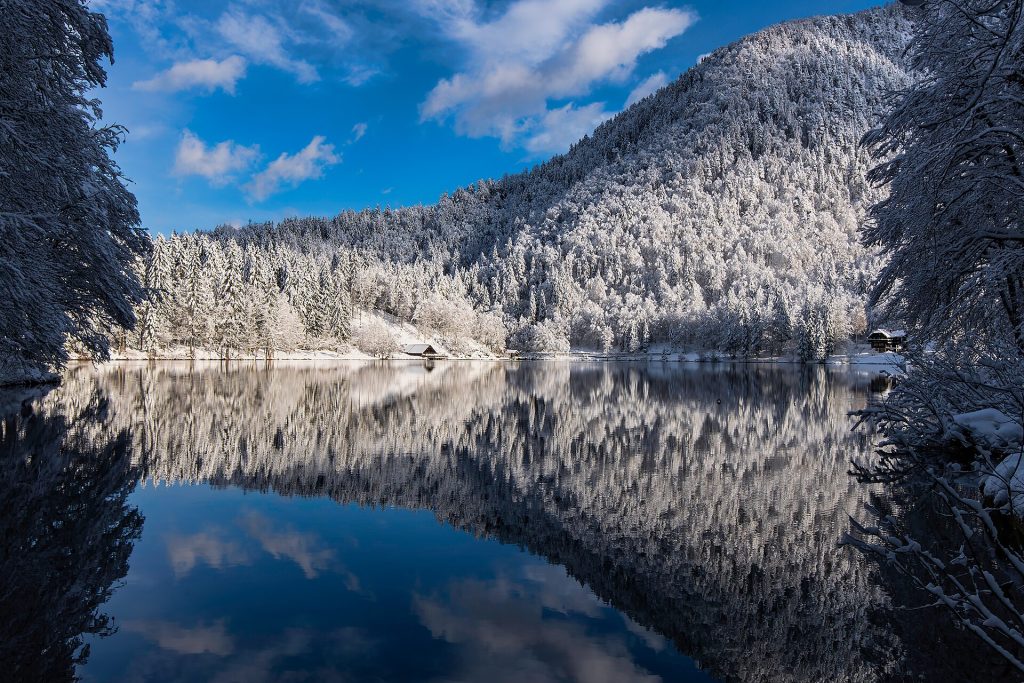
Lago di Fusine riflesso di Scosse, CC BY-SA 4.0, da Wikimedia Commons

Le acque del lago di Fusine diventano uno specchio per il paesaggio circostante in questo scatto invernale, dove la quiete del lago amplifica la presenza delle montagne e della natura della Conca di Fusine.

5. Il lago di Calaita al tramonto

Image
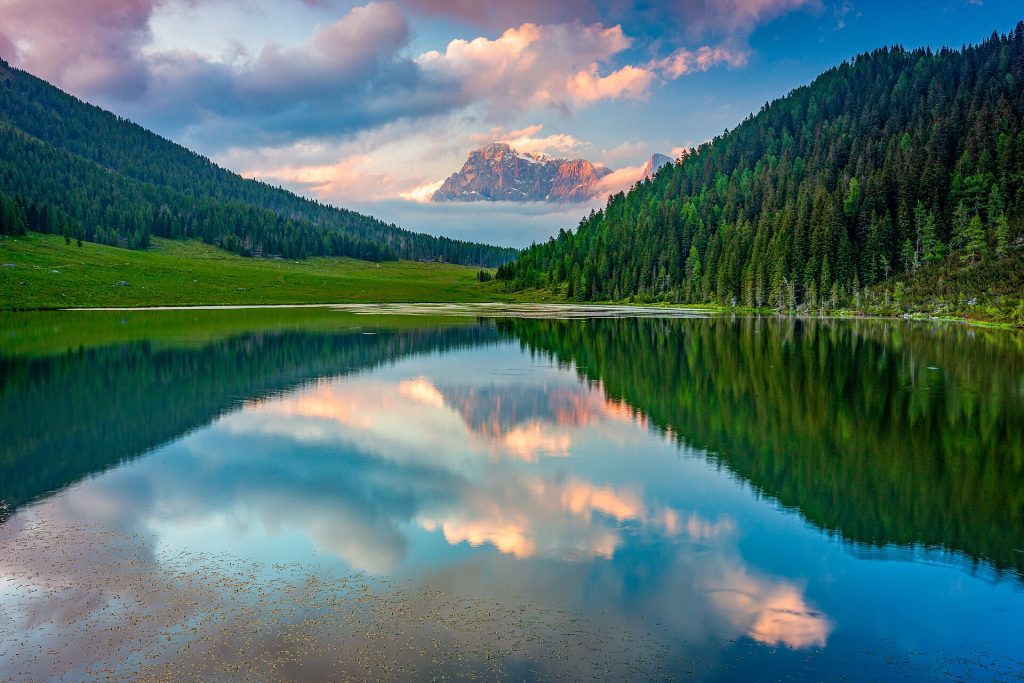
Il Lago di Calaita di Cesare Barillà, CC BY-SA 4.0, da Wikimedia Commons

Nel lago di Calaita si riflettono il cielo e le Pale di San Martino, illuminate dagli ultimi raggi del sole. Una fotografia che racconta la quiete della montagna attraverso il gioco di luce e riflessi.

Le foto vincitrici della categoria Macro e primi piani di animali, piante e funghi

La seconda categoria porta l’attenzione dagli scenari d’insieme ai dettagli della natura. Uccelli e mammiferi diventano così i soggetti principali di cinque fotografie che raccontano comportamenti, movimenti e momenti di vita selvatica.

1. Ciuffolotto in equilibrio

Image
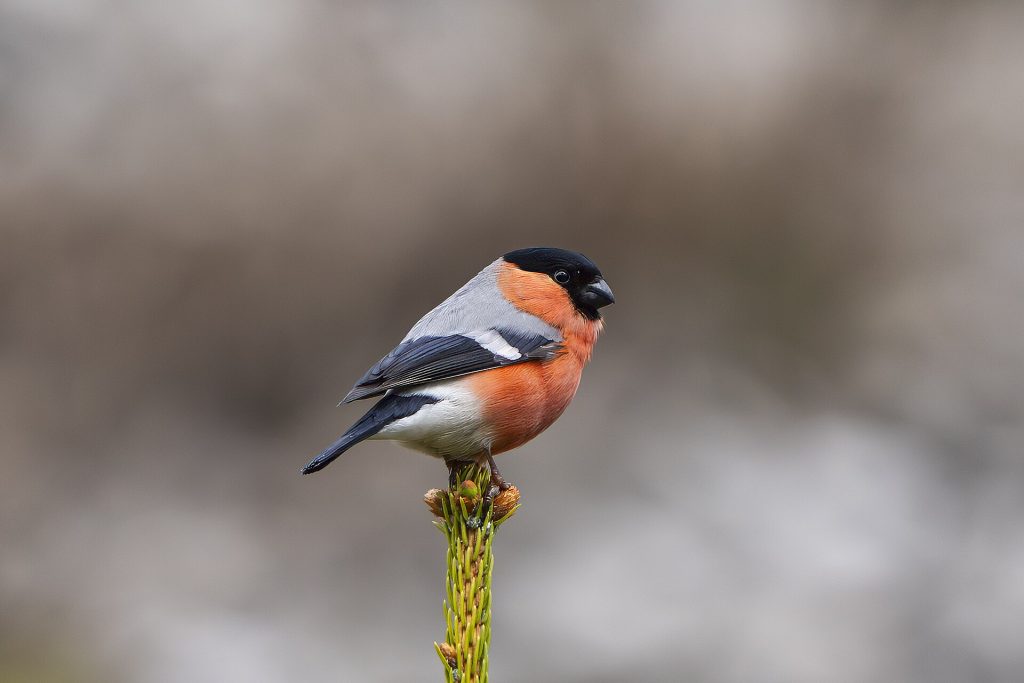
Ciuffolotto di Scosse, CC BY-SA 4.0, da Wikimedia Commons

Un ciuffolotto è colto in equilibrio nel suo ambiente naturale, in una fotografia dedicata alla fauna delle Alpi Carniche.

2. Svassi maggiore in lotta

Image
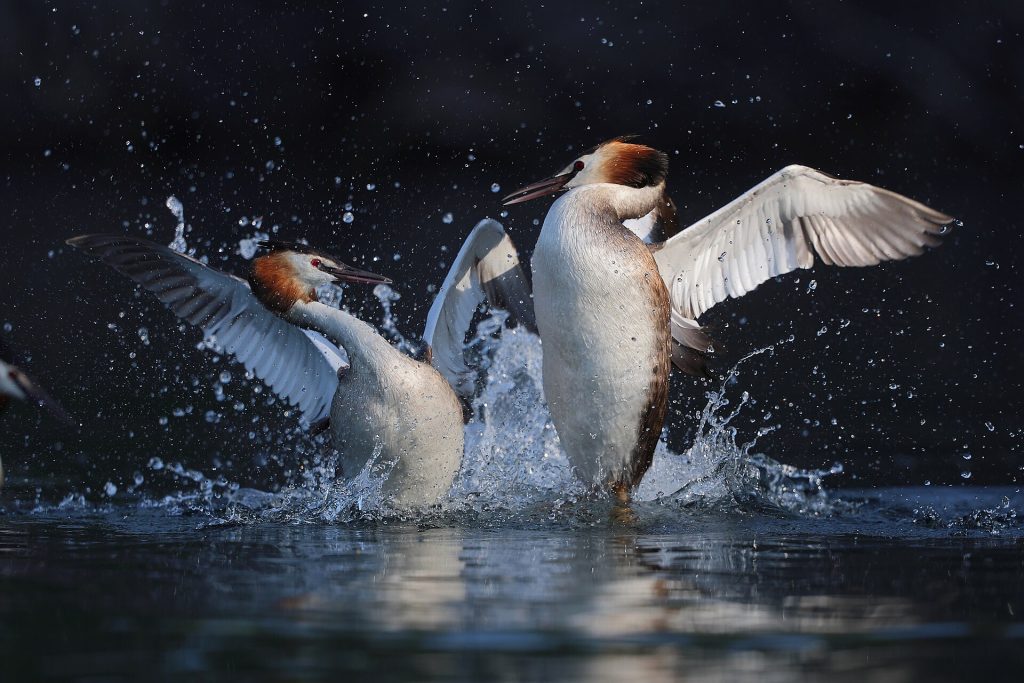
Svassi maggiore in lotta di LucaCasale1961, CC BY-SA 4.0, da Wikimedia Commons

Due svassi maggiori sono protagonisti di un momento di confronto sulle acque del Lago di Viverone, catturato in un’immagine dinamica e ricca di movimento.

3. Il richiamo

Image
Il richiamo di Maurizio Carlini, CC BY-SA 4.0, da Wikimedia Commons
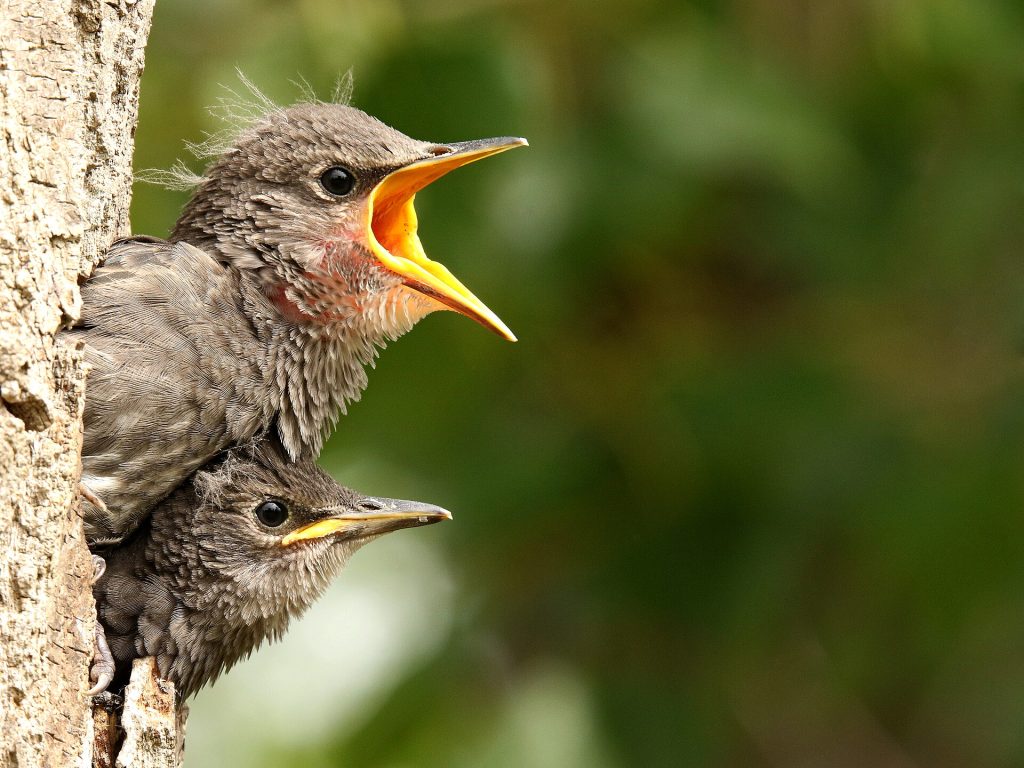
Un pullo di storno (Sturnus vulgaris) vocalizza a becco spalancato dall’ingresso del nido, richiamando i genitori. Un piccolo momento della vita quotidiana della fauna selvatica, osservato nel Greto dello Scrivia.

4. Anatra in immersione

Image
Anatra in immersione di Kodacat, CC BY-SA 4.0, da Wikimedia Commons
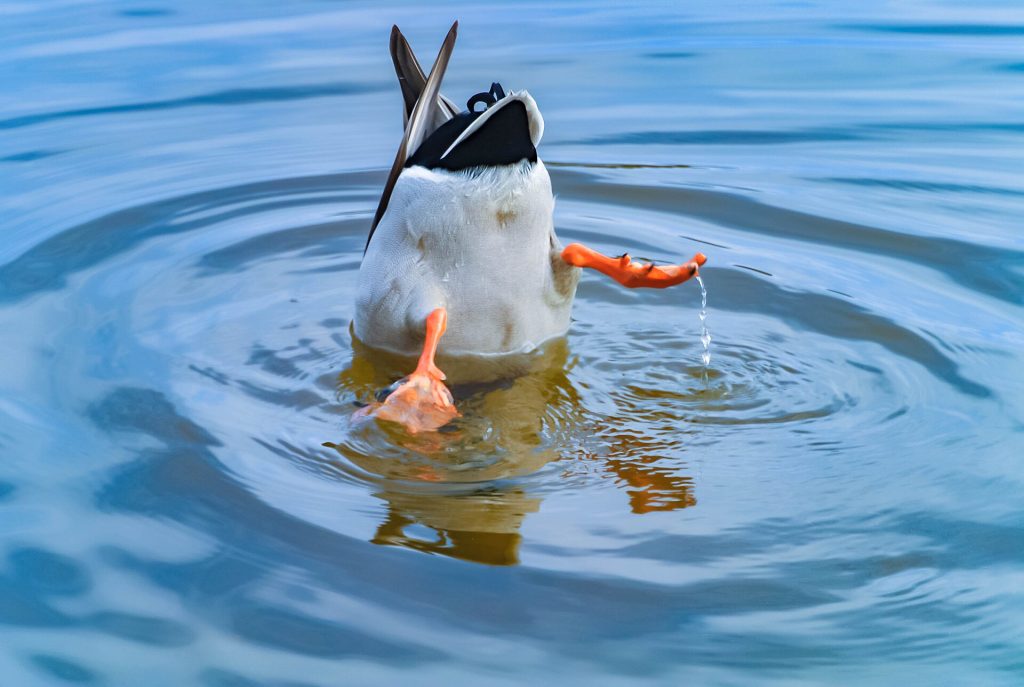
Un’anatra scompare sotto la superficie dell’acqua in uno scatto dedicato alla fauna della costa di Portonovo, tra mare e falesia calcarea.

5. Corri e va per la Terra

Image
Corri e va per la Terra di Domenico Marrano, CC BY-SA 4.0, via Wikimedia Commons

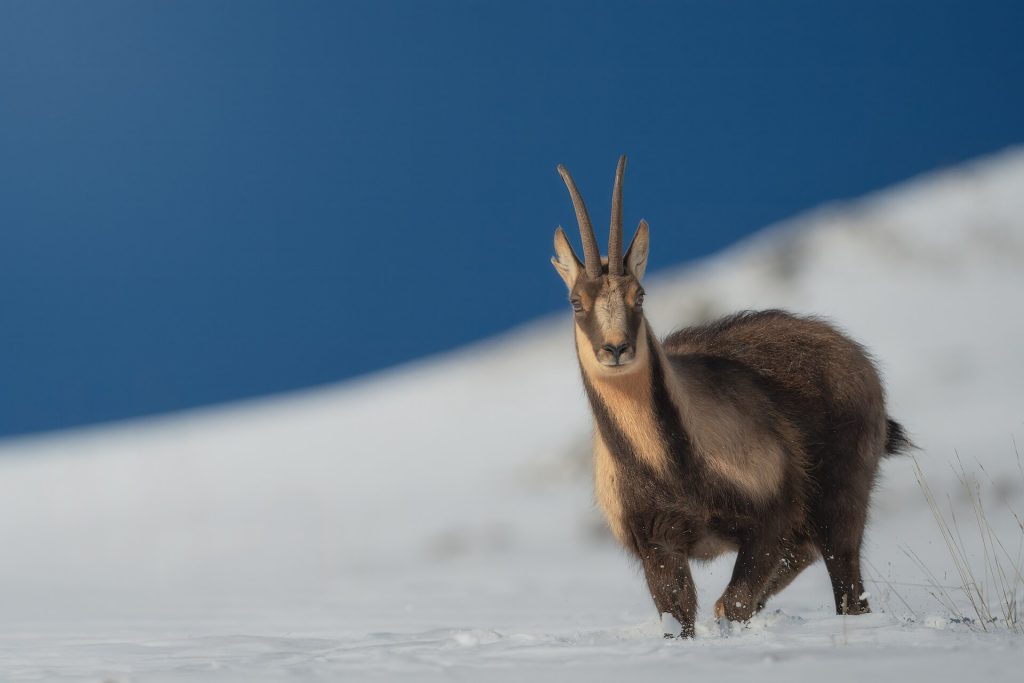
Chiude la selezione una fotografia dedicata alla rupicapra nel Parco nazionale dei Monti Sibillini, che restituisce tutta la vitalità della fauna dell’Appennino.

Clicca qui per visualizzare tutte le foto vincitrici di Wiki Loves Earth Italy 2026

Immagine in evidenza: Ciuffolotto di Scosse, CC BY-SA 4.0, da Wikimedia Commons
Come cambia il nostro modo di informarci nell’era dell’intelligenza artificiale? E quali competenze servono, soprattutto ai più giovani, per utilizzare questo strumento in modo consapevole?

È partito da queste domande l’intervento di Daniele Santini, vicepresidente di Wikimedia Italia, alla conferenza stampa svoltasi al Senato della Repubblica e promossa da ANGI, l’Associazione Nazionale Giovani Innovatori.

L’incontro ha messo al centro il rapporto tra nuove generazioni, formazione, lavoro e innovazione, presentando anche i risultati dell’Osservatorio LAB21 “Giovani, Innovazione e Futuro 2026”. Dalla ricerca emerge, tra gli altri dati, che il 47,1% degli intervistati individua nel digitale e nella tecnologia i settori con maggiore potenziale per la crescita dei giovani, mentre il 69,4% degli under 35 dichiara di sentirsi poco o per nulla rappresentato dalle istituzioni.

L’importanza dell’information literacy

In questo scenario, parlare di competenze digitali non significa soltanto imparare a utilizzare nuovi strumenti. L’intelligenza artificiale ha reso ancora più semplice accedere a una grande quantità di informazioni, ma proprio questa abbondanza rende più complesso distinguere ciò che è affidabile da ciò che non lo è. La capacità di orientarsi tra fonti diverse, verificarne l’attendibilità e riconoscere contenuti inaccurati, fake news o informazioni generate dall’IA diventa quindi sempre più importante.

È il tema dell’information literacy, cioè la capacità di cercare, valutare e utilizzare consapevolmente le informazioni. Come ha spiegato Santini nel corso del suo intervento, se l’intelligenza artificiale rende molto più semplice ottenere una risposta, diventa ancora più importante interrogarsi sulla qualità delle informazioni che riceviamo e sulle fonti che le sostengono.

Una risposta formulata in modo convincente non è necessariamente una risposta corretta.

La capacità di analizzare e verificare le fonti è quindi una delle competenze fondamentali da sviluppare. In questo percorso, ha sottolineato Santini, Wikipedia può rappresentare una vera e propria palestra: il suo funzionamento permette a chiunque di contribuire alle voci, ma richiede che le informazioni inserite siano supportate da fonti pubbliche e verificabili.

Imparare a confrontarsi con le fonti e a verificarne l’affidabilità significa quindi sviluppare concretamente quelle capacità di pensiero critico che diventano sempre più necessarie nell’attuale ecosistema informativo.

La data literacy

La seconda competenza indicata da Santini è la data literacy, ovvero la capacità di trovare, comprendere, interpretare e utilizzare i dati.

Nel panorama tecnologico attuale, ha spiegato, la quantità e la qualità dei dati disponibili possono avere un ruolo determinante tanto nella ricerca quanto nelle attività economiche e nell’innovazione. Per studenti, ricercatori e giovani innovatori diventa quindi fondamentale saper individuare fonti di dati affidabili e accessibili, anche per ridurre il divario informativo e strategico rispetto a realtà già strutturate e dotate di maggiori risorse.

In questo contesto assumono particolare valore le fonti di dati aperti, come OpenStreetMap e Wikidata, insieme agli open data messi a disposizione dagli enti pubblici. Si tratta di patrimoni informativi che possono essere consultati, analizzati e riutilizzati per sviluppare nuove ricerche, progetti e applicazioni.

Per Santini, la possibilità di accedere a questi dati rappresenta quindi non soltanto una questione tecnologica, ma anche un’opportunità per favorire l’accesso alla conoscenza e mettere a disposizione di studenti e giovani innovatori strumenti utili per il proprio lavoro.

La dimensione partecipativa

C’è infine una terza dimensione: quella della partecipazione.

Se i social network hanno reso più semplice comunicare, non significa necessariamente che abbiano migliorato la qualità della discussione pubblica. Allo stesso modo, osserva Santini, l’intelligenza artificiale può facilitare la produzione di contenuti e informazioni, ma non garantisce automaticamente che questi siano migliori o più affidabili.

Per questo è importante che i giovani non rimangano semplici fruitori passivi delle informazioni, ma possano diventare anche produttori e contributori attivi della conoscenza. Anche in questo caso i progetti di conoscenza aperta possono offrire uno spazio concreto per esercitare la collaborazione, il confronto e la partecipazione a una discussione pubblica costruttiva.

Wikipedia, in questa prospettiva, non è soltanto uno strumento da consultare, ma anche un progetto al quale contribuire: un ambiente in cui le persone possono partecipare alla costruzione di una conoscenza condivisa, confrontandosi con le fonti e con il contributo degli altri.

L’impegno di Wikimedia Italia nelle parole di Santini

A partire dai temi affrontati al Senato, Santini ha poi raccontato più nel dettaglio il lavoro di Wikimedia Italia e il ruolo dei giovani nell’associazione:

“Essere a Palazzo Madama è stata l’occasione per portare in un contesto istituzionale il punto di vista di chi, ogni giorno, costruisce conoscenza libera insieme a volontari e volontarie di tutte le età. L’intelligenza artificiale ha reso l’accesso all’informazione più semplice, ma ha anche reso più difficile distinguere ciò che è affidabile da ciò che non lo è. Per questo pensiero critico, verifica delle fonti e capacità di usare i dati aperti diventano competenze essenziali. Wikipedia e gli altri progetti aperti come Wikidata e OpenStreetMap sono un’ottima palestra: chiunque può contribuire, ma ogni informazione deve essere sostenuta da fonti verificabili. È lo spirito del laboratorio “Wikipedia e fake news al tempo dell’intelligenza artificiale”, che abbiamo portato al Book Pride di Milano nel 2025 e nel 2026 e che riproporremo all’edizione di Genova. Questi progetti insegnano anche a collaborare e a diventare autori della conoscenza, invece di semplici consumatori. In Wikimedia Italia i giovani non sono solo destinatari delle nostre attività, ma protagonisti: gli under 35 rappresentano un quinto dei soci, undici di loro ricoprono cariche sociali, due fanno parte del consiglio direttivo, e un gruppo di lavoro composto da giovani sta progettando attività e incontri pensati proprio per i loro coetanei. A chi vuole mettersi in gioco diciamo: unitevi a noi. Ai decisori chiediamo di fare la loro parte: portare l’educazione all’informazione nei programmi scolastici e rendere aperti, con licenze libere e in formati leggibili dalle macchine, i dati pubblici e il patrimonio culturale digitalizzato con fondi pubblici.”

Leggi anche: Che cos’è l’Agentic AI, come opera e a che punto siamo

Immagine in evidenza: Department of the Air Force launches NIPRGPT di U.S. Air Force, Pubblico dominio, da Wikimedia Commons

La storia della musica italiana è custodita in biblioteche, archivi e istituzioni culturali disseminati in tutto il Paese. Manoscritti, spartiti, libretti d’opera e volumi illustrati raccontano secoli di creatività, innovazione e scambi culturali che hanno contribuito a fare dell’Italia uno dei luoghi in cui la musica si è più sviluppata nel corso dei secoli.

Molti di questi materiali, però, restano accessibili soltanto a chi può raggiungere fisicamente le sedi che li conservano. Per studiosi, appassionati e cittadini, consultare queste collezioni significa spesso dover affrontare limiti geografici, logistici o economici.

Per contribuire a rendere questo patrimonio più accessibile nasce “Note condivise”, un progetto di Wikimedia Italia realizzato con i fondi Otto per mille della Chiesa Valdese.

Un patrimonio musicale da rendere davvero accessibile a tutti

L’obiettivo del progetto è trasformare una selezione di materiali storici conservati presso istituzioni culturali italiane in risorse digitali aperte, consultabili online e riutilizzabili liberamente.

Attraverso attività di digitalizzazione, metadatazione e pubblicazione sulle piattaforme Wikimedia, documenti che oggi possono essere consultati soltanto in sede diventeranno accessibili a tutti gratuitamente. Non si tratta quindi solo di conservare il patrimonio, ma di renderlo realmente fruibile, favorendo ricerca, studio, divulgazione e nuovi utilizzi in ambito educativo e culturale.

Le opere sono in pubblico dominio, e possono quindi essere condivise e riutilizzate senza restrizioni, contribuendo alla diffusione della conoscenza e alla valorizzazione della memoria culturale collettiva.

Da Torino a Palermo, Note condivise attraversa l’Italia

“Note condivise” è un progetto di Wikimedia Italia che coinvolge quattro istituzioni distribuite lungo tutta la penisola, accomunate dalla volontà di valorizzare e aprire al mondo il prezioso patrimonio musicale che custodiscono. 

Il Teatro Regio di Torino metterà a disposizione una selezione di libretti d’opera provenienti dal proprio archivio storico.

L’Associazione Musicale Estense di Modena contribuirà con antichi volumi illustrati tra XVI e XVIII secolo, caratterizzati da incisioni e xilografie di particolare interesse storico e artistico.

Il Conservatorio “Luigi Boccherini” di Lucca parteciperà con alcuni dei suoi fondi storici, tra cui raccolte dedicate alla musica sacra, alla musica antica e a importanti figure della storia musicale italiana come Giacomo Puccini e Alfredo Catalani. 

Da Palermo arriverà invece il contributo del Conservatorio “Alessandro Scarlatti”, che metterà a disposizione materiali legati al Fondo Florio, alla produzione musicale siciliana tra Ottocento e Novecento e a un importante corpus di musiche popolari dell’isola.

Il ruolo di Wikimedia Italia

Gli enti coinvolti metteranno a disposizione il patrimonio conservato nelle proprie collezioni, le loro competenze e gli spazi necessari alle attività.

Wikimedia Italia coordinerà invece il progetto e si occuperà delle attività di digitalizzazione, della metadatazione, della pubblicazione sui progetti Wikimedia e delle iniziative per promuovere la partecipazione della comunità e il riuso dei contenuti.

Accanto al lavoro sugli archivi, sono infatti previsti momenti pubblici e collaborativi, tra cui editathon, attività di valorizzazione e iniziative dedicate alla diffusione e all’utilizzo dei materiali digitalizzati da parte di scuole, università, istituzioni culturali e comunità di appassionati.

Wikimedia Italia per la diffusione del patrimonio musicale italiano

“Note condivise” fa parte di un percorso che Wikimedia Italia porta avanti da anni per favorire la diffusione aperta del patrimonio musicale e culturale italiano.

Nel tempo, infatti, l’associazione ha collaborato con realtà come l’Archivio Storico Ricordi, il Teatro alla Scala, il Teatro Regio di Torino e il Conservatorio di Santa Cecilia, contribuendo alla pubblicazione e alla valorizzazione di contenuti culturali sulle piattaforme Wikimedia.

Queste esperienze hanno permesso di sviluppare competenze specifiche nella digitalizzazione, nella gestione dei metadati e nella condivisione aperta di materiali culturali, che speriamo diventino modello per sempre nuove istituzioni interessate a rendere il proprio patrimonio accessibile a tutti.

Immagine: Aria C. Solo – Con Sinf.a – Del Sig.r Giuseppe Ferd.o Brivio – btv1b52514826k (05 of 12) (cropped) di Biblioteca nazionale di Francia, Pubblico dominio, da Wikimedia Commons

La Biblioteca del Conservatorio di Musica “Santa Cecilia” a Roma custodisce un importante patrimonio librario musicale storico. Il progetto dedicato alla sua digitalizzazione e diffusione nasce dalla collaborazione tra Wikimedia Italia e il Consiglio Nazionale delle Ricerche, avviata grazie al bando MAB 2025.

Nel 2026 Wikimedia Italia e il CNR hanno formalizzato una nuova collaborazione attraverso una convenzione per il biennio 2026-2027. È all’interno di questo quadro che si colloca, tra le altre, l’attività dedicata al Conservatorio Santa Cecilia.

L’iniziativa nasce con un duplice obiettivo: da una parte conservare e valorizzare materiali di grande rilevanza storica e documentaria, dall’altra renderli più facilmente accessibili alla ricerca, alla didattica e alla performance musicale. Attraverso l’infrastruttura globale dei progetti Wikimedia, il progetto punta inoltre a favorire la circolazione internazionale del patrimonio musicale conservato a Roma.

I tre nuclei documentari del progetto

Il progetto si concentra innanzitutto su tre importanti nuclei documentari.

Il primo è costituito dalle partiture e dagli spartiti musicali del fondo “Diritti d’autore”. Si tratta di materiali pervenuti alla Biblioteca grazie alla legge sul diritto di stampa, che nel 1883 dispose la trasmissione alla Biblioteca delle edizioni musicali provenienti da tutto il territorio nazionale.

Questa raccolta rappresenta una significativa testimonianza della cultura musicale italiana del XIX secolo. Le partiture e gli spartiti non sono quindi soltanto materiali destinati alla conservazione, ma documenti capaci di restituire una parte della produzione musicale italiana dell’epoca.

Il secondo nucleo è rappresentato dal fondo Silvestri, composto da 118 volumi che raccolgono circa 6.000 libretti di opere, feste teatrali e balli. La raccolta ha un particolare valore documentario perché permette di seguire le rappresentazioni musicali avvenute nei teatri di Milano e Monza dal 1670 al 1885.

Il terzo nucleo comprende invece circa 30.000 libretti d’opera e di balletto dei secoli XVII-XIX. Di questi, 21.138 titoli provengono dalla raccolta del collezionista portoghese Manoel Peixoto d’Almeida da Carvalhaes, mentre 9.700 appartengono al fondo Governativo dei libretti. Quest’ultimo documenta i repertori e l’attività dei teatri d’opera di tutta Europa.

I libretti come documenti storici

All’interno del progetto, i libretti occupano dunque uno spazio particolarmente significativo. La loro presenza in raccolte così ampie permette di documentare repertori, rappresentazioni e attività teatrali attraverso un arco cronologico molto esteso, dal XVII al XIX secolo.

La digitalizzazione permette di intervenire su questo patrimonio mantenendone il valore documentario e, allo stesso tempo, ampliandone le possibilità di accesso e consultazione.

Conservare e rendere accessibile il patrimonio musicale

Il progetto GLAM non si limita alla conservazione digitale dei materiali. L’obiettivo dichiarato è infatti quello di conservare e valorizzare il patrimonio musicale, ampliando l’accesso a risorse che possono essere utilizzate nella ricerca musicologica, nella didattica e nella performance musicale.

La collaborazione con la Biblioteca Centrale del CNR e l’utilizzo dell’infrastruttura globale dei progetti Wikimedia aggiungono inoltre una dimensione internazionale all’iniziativa. Materiali conservati a Roma possono così essere inseriti in un sistema che ne favorisce la circolazione e la conoscenza oltre i confini dell’istituzione che li custodisce.

Un progetto in crescita

Il progetto di digitalizzazione potrebbe in futuro essere esteso anche ad altri materiali conservati dalla Biblioteca: tra questi sono indicati il fondo di musica braille, i nastri magnetici e le lastre fotografiche.

L’eventuale ampliamento permetterebbe quindi di coinvolgere tipologie documentarie differenti, proseguendo il percorso di valorizzazione del patrimonio musicale storico attraverso la digitalizzazione.

La prospettiva è quindi quella di rendere questo patrimonio non soltanto conservato, ma anche accessibile, studiabile e condivisibile, favorendone la circolazione attraverso Wikimedia e mettendolo a disposizione di un pubblico più ampio.

Clicca qui per visualizzare le risorse disponibili su Wikimedia Commons

Immagine in evidenza: Esmeralda- pag. 1 (cropped) di Biblioteca del Conservatorio Santa Cecilia, CC BY-SA 4.0 , da Wikimedia Commons

Solidarietà ad Autistici/Inventati

Friday, 11 September 2026 14:15 UTC

Wikimedia Italia esprime la propria solidarietà al collettivo Autistici/Inventati che il 26 agosto è stato colpito da sanzioni economico finanziarie da parte del Dipartimento del Tesoro degli Stati Uniti a seguito della designazione come Specially Designated Global Terrorist (SDGT). 

Il provvedimento ha comportato il congelamento dei beni e il divieto per ogni cittadino americano di compiere transazioni o avere contatti con il collettivo. Da subito il dominio autistici.org è risultato inaccessibile e, il 6 settembre, Autistici/Inventati ha annunciato di dover chiudere, in primo luogo per tutelare i propri utenti e la propria comunità.

Il collettivo italiano Autistici/Inventati dal 2001 ha fornito infrastrutture digitali indipendenti (email, hosting, mailing list, chat, videoconferenze, streaming) tutelando la privacy e l’anonimato delle organizzazioni e delle persone che le utilizzavano. 

Proviamo profondo rammarico di fronte al silenziamento di una realtà che per 25 anni ha agito nel campo dei diritti digitali, della privacy e della libera comunicazione, e preoccupazione per come una decisione politica presa oltreoceano possa tradursi nella chiusura di un’associazione italiana, senza alcun pronunciamento ufficiale europeo o del nostro Paese. 

In un mondo digitale sempre più caratterizzato da concentrazione e oligopoli, dove gli spazi veramente pubblici e liberi sono sempre di più compressi, rappresenta un’inaccettabile attacco alle libertà digitali l’uso di strumenti dedicati alla lotta al terrorismo per chiudere una realtà indipendente che fornisce dei servizi liberi al pubblico.


Non possiamo non guardare con preoccupazione all’assimilazione del soggetto che fornisce un servizio neutrale e libero di hosting di contenuti con l’utente finale che ne fruisce.

Le norme a tutela di chi mette a disposizioni questi servizi sono presenti sia nell’ordinamento statunitense (cd. limiti alla intermediary liability) sia in quello europeo, e sono applicabili tanto alle grandi aziende quanto alle realtà senza scopo di lucro e create dal basso, esattamente come Wikipedia e i progetti Wikimedia.
È un problema che ci tocca direttamente come associazione che opera per la libertà di informazione, la conoscenza libera e la tutela della privacy nel web.

Il direttivo di Wikimedia Italia

Ferdinando Traversa, Daniele Santini, Elena Marangoni, Mattia Nappi, Marco Montanari

Dal 13 giugno al 1° agosto 2026 si è svolta la settima edizione del laboratorio “I progetti Wikimedia per i beni culturali”, inserito nel Master di secondo livello in Digital Humanities dell’Università degli Studi di Milano. L’attività ha coinvolto 27 studenti e ha proposto un percorso pratico dedicato alla conoscenza e all’utilizzo di Wikipedia e degli altri progetti Wikimedia per la valorizzazione e la diffusione del patrimonio culturale.

Il laboratorio, svolto interamente online in modalità live, ha accompagnato gli studenti dalla conoscenza delle principali regole di Wikipedia fino alla realizzazione e pubblicazione di contenuti enciclopedici, con particolare attenzione ai beni culturali.

I docenti e gli obiettivi del laboratorio

Il laboratorio è stato curato da Marco Chemello, formatore e responsabile scuola/università dello staff di Wikimedia Italia, e Luigi Catalani, direttore della Biblioteca nazionale di Potenza, che hanno seguito gli studenti nelle diverse fasi del percorso.

L’obiettivo è stato quello di fornire agli studenti gli strumenti necessari per contribuire in modo consapevole ai progetti Wikimedia, imparando a utilizzare Wikipedia come spazio di produzione e condivisione della conoscenza sul patrimonio culturale.

Nel corso degli incontri sono stati affrontati i principi fondamentali di Wikipedia, le modalità di scrittura e revisione delle voci, la ricerca e l’utilizzo delle fonti, il diritto d’autore e le licenze libere, oltre alle possibilità offerte da Wikimedia Commons e Wikidata. La panoramica è stata accompagnata da un’attività laboratoriale continua: ogni partecipante ha infatti scelto un argomento su cui lavorare, sviluppando progressivamente una voce nella propria sandbox fino alla revisione finale e alla pubblicazione.

L’attività ha permesso così di collegare le competenze proprie delle Digital Humanities con le pratiche dell’open knowledge, trasformando il lavoro degli studenti in nuovi contenuti accessibili e riutilizzabili online.

Il programma del laboratorio

Primo incontro: conoscere Wikipedia e iniziare a contribuire

Il laboratorio si è aperto con un’introduzione ai progetti Wikimedia e alle attività previste. La prima parte è stata dedicata a Wikipedia, ai suoi cinque pilastri e ai principi fondamentali che regolano la partecipazione all’enciclopedia libera.

Tra il primo e il secondo incontro gli studenti hanno iniziato a individuare il tema della propria voce, privilegiando argomenti legati ai beni culturali e verificando la disponibilità di una bibliografia adeguata.

Secondo incontro: fonti, progetti Wikimedia e scrittura

Il secondo appuntamento ha ampliato la conoscenza dell’ecosistema Wikimedia, introducendo anche le basi di Wikisource e Wikivoyage e presentando il concorso fotografico Wiki Loves Monuments.

La parte centrale dell’incontro è stata dedicata al laboratorio di scrittura: gli studenti hanno continuato a sviluppare le proprie voci, lavorando in particolare sull’utilizzo delle fonti e sulla corretta organizzazione di note e bibliografia.

Terzo incontro: immagini, diritto d’autore e Wikimedia Commons

Il terzo incontro ha portato l’attenzione sui contenuti multimediali e sulle modalità di utilizzo delle immagini nei progetti Wikimedia.

Una parte importante della lezione è stata dedicata al diritto d’autore, alle immagini in pubblico dominio e alle licenze libere. Gli studenti hanno approfondito il funzionamento di Wikimedia Commons e le modalità corrette per caricare e descrivere i file.

Quarto incontro: Wikidata e la dimensione dei dati

Il laboratorio ha quindi affrontato Wikidata, il progetto Wikimedia dedicato alla gestione strutturata dei dati.

Dopo una prima introduzione al funzionamento della piattaforma, gli studenti hanno lavorato sull’arricchimento degli elementi relativi ai beni culturali oggetto delle proprie voci e sulla creazione di nuovi elementi quando necessario.

Parallelamente è proseguito il lavoro editoriale sulle voci di Wikipedia, ormai giunte alla fase conclusiva.

Quinto incontro: revisione e pubblicazione

L’ultimo appuntamento è stato dedicato alla revisione finale delle voci e alla loro pubblicazione.

Prima della pubblicazione, gli studenti hanno avuto la possibilità di sottoporre più volte le proprie bozze alla revisione dei docenti, intervenendo sui contenuti, sulle fonti, sulla struttura e sugli aspetti formali.

La fase conclusiva ha riguardato anche le attività successive alla pubblicazione, come l’inserimento delle categorie, il collegamento con Wikidata e la disorfanizzazione delle nuove voci, per favorire una loro migliore integrazione all’interno dell’enciclopedia.

I risultati

Il laboratorio ha coinvolto 27 studenti, ciascuno impegnato nella creazione, traduzione o ampliamento di contenuti su Wikipedia.

Il lavoro documentato sulla pagina del progetto comprende 16 voci ampliate, 9 nuove voci create e 2 voci tradotte, per un totale di 27 soggetti. Tra gli argomenti affrontati figurano opere letterarie, artisti, edifici e complessi monumentali, istituzioni culturali, opere d’arte e altri temi legati al patrimonio culturale.

Tra le voci ampliate o create dagli studenti si trovano, ad esempio, Patera di Parabiago, Villa Strohl Fern, Padiglione d’arte contemporanea di Milano, Abbazia di San Benedetto in Polirone, Fabbrica del Duomo di Como e Archivio storico del Comune di Catania. Il progetto comprende inoltre attività di traduzione di voci provenienti da altre edizioni linguistiche di Wikipedia.

Il percorso ha quindi prodotto non soltanto un’esperienza formativa per gli studenti del Master, ma anche un insieme di nuovi contenuti e miglioramenti destinati a rimanere disponibili nell’enciclopedia libera.

Il laboratorio rappresenta così un esempio concreto di come la formazione universitaria possa incontrare l’open knowledge: gli studenti non si limitano ad apprendere il funzionamento degli strumenti digitali, ma li utilizzano per produrre nuova conoscenza, mettendola a disposizione di un pubblico potenzialmente globale.

Clicca qui per vedere le statistiche di tutte le edizioni del corso

Immagine in evidenza: Chiostro di San Bendetto dell’Abbazia di San Benedetto in Polirone (cropped) di Sbezz, CC BY-SA 4.0, da Wikimedia Commons
Dal 1° al 30 settembre torna Wiki Loves Monuments, il concorso fotografico che invita tutti a documentare il patrimonio culturale italiano e a condividerlo con milioni di persone. Al concorso tradizionale si affianca quello tematico, quest’anno dedicato a ville e palazzi storici.

Ci sono posti che attraversiamo ogni giorno, spesso senza guardarli davvero. Sono palazzi, ville, chiese, monumenti: tutti luoghi che raccontano la storia e la cultura del nostro Paese.

Wiki Loves Monuments nasce per svelarli e renderli accessibili a tutti. 

Organizzato da Wikimedia Italia con la collaborazione di FIAF – Federazione Italiana Associazioni Fotografiche e il patrocinio di Anci, il  concorso invita fotografi e appassionati a raccontare il patrimonio culturale italiano attraverso immagini rilasciate con licenza libera, disponibili su Wikimedia Commons, Wikipedia e sugli altri progetti Wikimedia.

Come partecipare

Partecipare al concorso è semplice: dal 1° al 30 settembre basta accedere alla web app di Wiki Loves Monuments con il proprio account (non hai ancora un account? Crealo ora) e caricare le proprie immagini di monumenti. Non è necessario scaricare l’app.

Le fotografie possono essere state scattate anche in precedenza: l’importante è caricarle durante il mese di settembre 2026. 

Per conoscere i monumenti che possono partecipare, basta consultare la web app di Wiki Loves Monuments, che permette di esplorare le liste dei beni culturali in concorso e individuare quelli presenti sul proprio territorio. 

Le 10 foto migliori scelte dalla giuria nazionale rappresenteranno l’Italia al concorso internazionale.

Leggi il regolamento del concorso

Con Wiki Loves Monuments 2026 condividi la cultura con il mondo

Le fotografie caricate durante il concorso saranno pubblicate su Wikimedia Commons, l’archivio multimediale libero e gratuito che alimenta Wikipedia e gli altri progetti Wikimedia, contribuendo a far conoscere la ricchezza del patrimonio culturale italiano a milioni di persone in tutto il mondo.

“Ogni fotografia caricata durante Wiki Loves Monuments è un contributo concreto all’ecosistema più ampio della conoscenza libera, che include Wikipedia e il suo archivio fotografico. Non si tratta solo di partecipare a un concorso, ma di mettere a disposizione di milioni di persone immagini liberamente riutilizzabili, che potranno essere consultate, studiate e utilizzate in tutto il mondo. È questo il valore delle iniziative che Wikimedia Italia promuove ogni giorno: trasformare la conoscenza in un patrimonio condiviso, accessibile a tutti e costruito grazie all’impegno di ciascuno. Con Wiki Loves Monuments tutti siamo chiamati in prima persona a documentare, valorizzare e quindi promuovere i luoghi che ci circondano”, ha dichiarato Ferdinando Traversa, Presidente di Wikimedia Italia.

I concorsi locali

Accanto al concorso nazionale, i volontari di Wikimedia Italia organizzano anche quest’anno una serie di concorsi locali. Un modo per valorizzare ancora di più il patrimonio delle nostre regioni e svelare al mondo la bellezza dei luoghi meno conosciuti del nostro Paese. Le immagini che parteciperanno ai concorsi locali concorreranno automaticamente anche a quello nazionale.

Per conoscere i concorsi attivi, le iniziative e le wikigite organizzate nelle varie regioni, è possibile consultare le informazioni disponibili sulla pagina dedicata ai concorsi locali di Wiki Loves Monuments Italia.

Sostieni Wiki Loves Monuments

Wiki Loves Monuments Italia e la sua web app sono promossi da Wikimedia Italia. Se vuoi, puoi sostenere i nostri progetti e aiutarci a diffondere la conoscenza libera con una donazione.

Per avere maggiori informazioni sul concorso e sulle modalità di partecipazione è possibile scrivere una mail all’indirizzo contatti@wikilovesmonuments.it.

Il 20 agosto il fondatore di Wikipedia Jimmy Wales ha presentato a Fano il suo libro Le 7 regole della fiducia. Un’occasione per riflettere sul valore della collaborazione tra le persone, della trasparenza e della conoscenza libera in un’epoca segnata dalla disinformazione e dall’intelligenza artificiale.

Fidarsi oggi sembra essere sempre più difficile. Eppure è proprio sulla fiducia che, venticinque anni fa, è stata costruita Wikipedia: l’idea, allora considerata da molti impossibile, che migliaia di persone sconosciute potessero collaborare per creare insieme una grande enciclopedia libera.

Di questo ha parlato Jimmy Wales, fondatore di Wikipedia, durante la presentazione italiana del suo libro Le 7 regole della fiducia, che si è svolta il 20 agosto a Fano, nelle Marche. La città è stata scelta come prima tappa del tour italiano del volume, un luogo non casuale: proprio alla Mediateca Montanari di Fano Wales ha iniziato a lavorare al libro alcuni anni fa.

La presentazione davanti a 600 persone

L’incontro, organizzato dal Comune di Fano attraverso il Sistema Bibliotecario cittadino, ha registrato un interesse tale da parte del pubblico che è stato necessario sostarlo al Teatro della Fortuna. Wales ha dialogato con Alessandro Bogliolo, professore dell’Università degli Studi di Urbino Carlo Bo e direttore dell’AIMRC – Artificial Intelligence Multidisciplinary Research Center.

L’incontro è stato introdotto da Ferdinando Traversa, presidente di Wikimedia Italia.

Nel suo intervento, Traversa ha ripercorso alcuni passaggi fondamentali della storia del progetto, dai primi anni di vita fino al traguardo dei venticinque anni appena celebrato, sottolineando come il successo di Wikipedia sia stato possibile grazie alla fiducia reciproca, all’impegno dei volontari e alla condivisione di una missione comune: garantire a ogni persona libero accesso alla conoscenza.

«Wikipedia è innanzitutto, prima ancora che un’enciclopedia, una grande comunità di persone. Persone che collaborano, discutono, a volte dissentono, ma cercano sempre un punto di incontro».

La fiducia non è credere senza verificare

Il tema della fiducia, al centro del libro, è emerso anche nel confronto sulla storia di Wikipedia. Alla domanda su che cosa abbia permesso a un progetto nato nel 2001 di trasformarsi in una grande comunità di collaboratori, Wales ha parlato di un elemento che va oltre la semplice «intelligenza collettiva».

«Ovviamente la conoscenza è umana»: nasce dalla mente delle singole persone che contribuiscono e cercano di fare bene il proprio lavoro. Ma, ha aggiunto, serve anche un contesto sociale che incoraggi gentilezza e ragione.
È qui che Wikipedia si distingue anche dagli ambienti sociali nei quali il conflitto può essere alimentato dalle stesse dinamiche della piattaforma.

Per Wikipedia, invece, la collaborazione richiede un obiettivo comune e strumenti per gestire i conflitti. Wales ha citato il ruolo degli amministratori, che contribuiscono a mantenere un ambiente nel quale le persone possano collaborare e intervengono quando qualcuno non rispetta le regole della comunità.

La fiducia di cui parla Wales non è una fiducia cieca nelle persone, né tantomeno l’idea che una comunità non debba avere conflitti. È la costruzione di un ambiente nel quale esistano un obiettivo condiviso, regole funzionali a quell’obiettivo, possibilità di discutere, fonti verificabili e trasparenza.

Wikipedia e l’intelligenza artificiale

Il confronto con l’intelligenza artificiale generativa è arrivato naturalmente nel corso dell’intervista. Alla domanda di Bogliolo se ChatGPT sarebbe mai esistita senza Wikipedia, Wales ha risposto scherzando che se fosse stata costruita lavorando su X o Twitter, sarebbe stata «molto stupida e molto arrabbiata».

Dietro la battuta c’è però una riflessione più seria sulla differenza tra i due modelli.

Secondo Wales, uno dei problemi principali dei grandi modelli linguistici (LLM) è che non comprendono la verità: lavorano sulla probabilità delle parole e possono quindi produrre informazioni inventate che, proprio perché formulate in modo convincente, sembrano vere.

Wikipedia offre una conoscenza verificabile come un dono al mondo e, in cambio, chiede soprattutto l’attribuzione. Il problema, ha osservato, è che i modelli linguistici possono utilizzare informazioni provenienti da Wikipedia senza rendere evidente all’utente che quella conoscenza arriva da lì.

La scommessa di Wikipedia

Alla presentazione di Fano Wikipedia non è stata soltanto l’oggetto del racconto del suo fondatore. È stata anche un esempio concreto di come una comunità possa costruire conoscenza attraverso collaborazione, regole, trasparenza e fiducia. Un tema che, nel dialogo con Bogliolo, ha permesso a Wales di guardare al futuro di Wikipedia e al rapporto sempre più stretto tra conoscenza umana e intelligenza artificiale.

La scommessa di Wikipedia, a 25 anni dalla sua fondazione, continua a basarsi sull’intelligenza e sulla capacità di collaborare delle persone.

Immagine: Editathon e presentazione del libro di Jimmy Wales a Fano – 20 agosto 2026 (27743) di Accurimbono, CC BY-SA 4.0, da Wikimedia Commons
La voce su di me in Wikipedia

Tuesday, 7 April 2026 02:51 UTC

la voce su di me in it.wiki Sono più di vent’anni che edito Wikipedia. Ma come sapete faccio tante cose, e ogni tanto qualcuno pensa che almeno Wikipedia in lingua italiana dovrebbe avere una voce su di me. (C’è da una vita un Maurizio Codogno, ma è un ex calciatore e allenatore mio omonimo). Io non sono per nulla d’accordo, e ho cancellato più volte la voce su di me: l’ultima lo scorso settembre. Probabilmente sono uno dei pochi che di avere una voce biografica non se ne fa nulla: tanto c’è già fin troppa roba che ho scritto e di me si può sapere praticamente tutto.

Purtroppo però la scorsa settimana un utente di Wikipedia ha scoperto che io sono automaticamente “enciclopedico”, vale a dire rilevante, secondo le regole di Wikipedia, in qualità di scrittore. Per la precisione uno scrittore è ritenuto enciclopedico se lo è almeno un suo libro, e un libro è enciclopedico se è stato tradotto almeno in tre lingue, cosa che è vera per Matematica in pausa caffè. A questo punto non posso fare nulla: ok, potrei far cancellare la voce per minacce legali, ma non mi sembra il caso. Quindi la voce c’è. (Quella nel link è la versione di venerdì scorso, un giorno dopo la (ri)creazione e la segnalazione delle traduzioni di Matematica in pausa caffè; nel frattempo è stata aggiunta una mia foto)

Peccato che per fare una cosa così tanto valeva non farla, a partire dalla definizione di “scrittore” nel titolo. Ovvio, bisogna specificare in qualche modo di quale Maurizio Codogno si parla, e la mia rilevanza deriva da un libro che ho scritto: ma direi che non sono uno scrittore, al più un divulgatore. Ma tutto il corpo della voce non funziona. Ecco alcuni esempi:

  • Del resto quell’elenco è sbagliato, c’è una lingua per cui sono stati venduti i diritti di traduzione ma non è mai stato tradotto il testo.
  • Anche senza considerare i libri autopubblicati – di cui non vedrei il problema, essendo un di più irrilevante per l’enciclopedicità ma comunque esistente – mancano vari testi che ho pubblicato con case editrici vere (e per cui non ho pagato, anzi…)
  • Se guardate le altre biografie di scrittori contemporanei (quelli veri) noterete come la bibliografia non si limita a mettere titolo e anno di pubblicazione, ma aggiunge editore e ISBN. Qui niente.
  • La “biografia” scritta così è una barzelletta: a parte tutte le cose interessanti che ho fatto nella mia vita e che a questo punto si potevano anche citare, mancano almeno tre cose che ho fatto come scrittore.
  • Mancano i link ad altre parti del mondo wiki dove c’è roba mia. (Non di sola Wikipedia vive l’uomo.) I cosiddetti “interwiki” sono alla base di un’enciclopedia multimediale.

Ieri pomeriggio era finalmente stato tolto il “matematico” nella mia descrizione: che avrei fatto di rilevante in matematica? Ieri sera è stato rimesso, con la motivazione che il famigerato testo enciclopedico è di matematica. Lasciamo stare.

Burocraticamente potrei editare io stesso la voce e correggerla: basta che io indichi di essere in conflitto di interessi (e ovviamente non faccia modifiche promozionali), e usi fonti terze e non il mio sito. Il punto è che io per principio non intendo toccare quella voce che ritengo assolutamente inutile né dire quali sono le cose che mancano e quali errori ci sono: è tutto materiale che si può trovare in rete, mica sono segreti di stato. Questo è del resto uno dei più grandi guai di Wikipedia, soprattutto con le biografie di persone viventi. Anche ammettendo che una voce non venga scritta con l’unico scopo di fare o farsi pubblicità, quello che sembra l’unica cosa importante è dire “ho messo una nuova voce nell’enciclopedia!” senza darsi la pena di renderla almeno un minimo decente. Non lo si vede molto spesso perché in genere il lavoro è fatto alla rovescia, partendo da un testo prolisso e promozionale a cui qualche anima pia toglie le parti inutili e dannose: ma togliere è molto più facile che aggiungere, dato che nel secondo caso bisogna fare delle ricerche per recuperare il materiale e non è detto che la cosa sia banale. Controprova? La mia enciclopedicità è legata a quella di Matematica in pausa caffè. C’è una voce sul libro? Ovviamente no, per farla bisognerebbe come minimo cercare i dati e qualche recensione, se proprio non lo si vuole leggere. Avete presente la fatica necessaria?

PS: Non ho nessuna pregiudiziale contro l’essere presente nei siti dei progetti wiki. Per dare un’idea, quando riottenni i diritti di Matematica in relax chiesi a chi frequentava Wikisource se fossero interessati ad avere il testo: ricevuta risposta positiva (essendo il libro stato pubblicato da un editore non a pagamento esso era idoneo) ho provveduto a caricarlo e quindi da qualche anno c’è una voce su di me in Wikisource. Ma lì appunto la mia presenza come autore ha un senso: su Wikipedia, no.

Ultimo aggiornamento: 2026-04-07 11:58

Un paio di cose su Wikipedia

Thursday, 2 April 2026 02:51 UTC

È un po’ che non scrivevo di Wikipedia: il tempo è poco e le cose da fare sono molte. Dovrei anche parlare della chiusura di Wikinews, ma sarà per un’altra volta. Per il momento segnalo due articoli piuttosto diversi ma che fanno capire come 25 anni sono un bel peso per l’enciclopedia.

Il primo articolo, pubblicato su Link, è in realtà fuorviante e lo segnalo solo perché è un classico esempio di una traduzione che non ha davvero molto senso. È vero che la Wikipedia in lingua inglese ha voci francamente bizzarre per non dire peggio, ma ogni edizione linguistica ha le sue regole interne e in quella italiana queste voci sono generalmente eliminate, così come quelle di eventi che probabilmente tra una settimana saranno dimenticati. Questo non vuol dire che non ci siano voci che uno non si aspetterebbe in un’enciclopedia, come per esempio “igiene anale” (la voce sull’orientamento dei rotoli di carta igienica è stata assorbita da quella sulla carta igienica su Wikipedia in lingua italiana, ma rimane in quella in inglese e in altre 19 edizioni linguistiche). Diciamo che molto spesso gli articoli di costume su Wikipedia sono semplici traduzioni e quindi essenzialmente anglocentrici.

Più interessante quest’altro articolo di Dariusz Jemielniak (uno che di Wikipedia ne sa, oltre che essere un accademico.) Il suo punto di vista è che Wikipedia è nata venticinque anni fa da nerd ventenni, massimo trentenni (io avevo già passato i quaranta, ma si sa che sono anzyano) e ora ci sono sempre loro, diventati ormai cinquantenni e quindi pompieri da incendiari che erano. Tutte le modifiche proposte per “semplificare” fruizione e contribuzione a Wikipedia sono così state bloccate, e questo sarebbe un male. Ora, posso assicurarvi che la prima versione del Visual Editor che si voleva rendere obbligatoria per modificare le voci era una cosa del tutto inusabile. (Ora funziona abbastanza bene, ma sono passati tredici anni…) Dal mio punto di vista il problema è appunto che le nuove feature introdotte dagli sviluppatori sono spesso in versione alfa, e sono introdotte nella speranza che vengano debuggate “sul campo”: ma gli editor abituali non hanno voglia di perdere tempo, e gli utenti casuali si trovano ancora più persi. Più interessante l’altro punto portato da Dariusz, e che riguarda direttamente i lettori. Visto che ormai le nuove generazioni non sono in grado di leggere direttamente un testo complesso ma hanno bisogno di un riassuntino, così come i capi e capetti, l’idea della Wikimedia Foundation era stata quella di creare i “Simple Article Summaries”, generati per mezzo dell’IA. La comunità anglofona ha avuto una reazione contraria così violenta che dopo un giorno la feature è stata eliminata.

Parliamone un po’. Sul fatto che un riassunto breve e semplice, almeno per le voci più lette, sarebbe utile penso che tutti siamo d’accordo. E del resto la Wikipedia delle origini era molto più ruspante. E possiamo anche immaginare che un LLM bene addestrato non farebbe molte allucinazioni e soprattutto possiamo sperare che userebbe solo il testo della voce per fare il riassunto, e non aggiungerebbe altre informazioni prese chissà dove. Ma siamo sicuro di volere passare a un modello IA, quando il valore aggiunto di Wikipedia è che nel bene o nel male il materiale è generato da utenti reali? Io potrei al più accettare un pulsante che ti porti fuori da Wikipedia (anche se su un server della Wikimedia Foundation) e mi creasse lì il riassunto: ma voglio che due cose essenzialmente diverse siano in posti essenzialmente diversi. Sono anch’io un vecchio bacucco? Probabile. Ma non ce lo ordina il dottore di usare Wikipedia: possiamo sempre andare da Elonio e dalla sua Grokipedia, se proprio vogliamo essere moderni.

Wikipedia e l’IA

Monday, 3 November 2025 03:51 UTC

L’altro giorno, parlando di Grokipedia, ho accennato al fatto che Wikipedia deve per forza fare i conti con l’intelligenza artificiale. Qui provo a spiegare come io vedo la situazione. Premetto che tutto quello che scrivo riflette esclusivamente il mio pensiero, non quello della comunità di Wikipedia in lingua italiana, di Wikimedia Italia o tanto meno della Wikimedia Foundation.

Il primo punto da considerare è capire perché usare l’IA. Attenzione: non sono luddista, e non ho nulla a priori contro il suo uso. Spero però che nessuno creda davvero che gli LLM siano creativi, riuscendo quindi a scrivere qualcosa di davvero nuovo e non rimasticato (pur molto bene): d’altra parte se ci riuscissero il testo sarebbe considerato una ricerca originale (RO) che in Wikipedia è assolutamente vietata, perché tutto deve essere verificato indipendentemente. (Nota: mentre sto scrivendo c’è una curiosa convergenza tra utenti destrorsi e sinistrorsi che stanno cercando di far passare il concetto che le ricerche originali si possono usare). E taciamo sul fatto che le “ricerche originali” degli LLM sono spesso cose che non stanno né in cielo né in terra: ultimamente abbiamo avuto l’utente LugAIno che scriveva testi più o meno casuali sulla città di Lugano. Aggiungiamo poi che c’è il gtrande rischio che il testo generato, specialmente se si parla di un argomento di nicchia, potrebbe essere troppo simile alla fonte originale e pertanto essere una violazione di copyright. Non sapere quali siano le fonti non ci permette nemmeno di scoprirlo.

Da qui si passa al secondo punto: Wikipedia richiede di inserire le fonti delle affermazioni indicate, cosa che di solito non si ha con gli LLM: ci sono delle eccezioni, come Copilot e Perplexity, ma anche se loro affermano di indicare da dove hanno preso le informazioni questo non significa molto. L’altra settimana per esempio, chiedendo a Perplexity quando una chiesa milanese era stata eretta come basilica minore, Perplexity mi “citò una fonte” secondo cui il decreto relativo era stato emesso nel luglio 2025… da papa Francesco.

Ciò detto, non c’è nessuna ragione intrinseca per vietare tout court l’uso dell’IA per migliorare le voci: quello che serve è che non si copincolli il testo creato ma lo si controlli e lo si corregga dove necessario. Alcuni esempi di uso dell’IA? Il recupero di fonti (reali…) che possono utilmente ampliare quanto già scritto; la revisione di un testo in modo che sia più scorrevole; la traduzione di quanto già presente in un’altra edizione linguistica di Wikipedia (ma in questo caso ricordatevi di citarla come fonte!). L’IA è molto brava a fare il lavoro sporco, proprio perché in pancia ha una quantità enorme di informazioni. L’importante è appunto non dimenticarsi che l’intervento umano continua a essere necessario.

Ultimo aggiornamento: 2025-12-29 18:46

Il Codice Urbani vale solo in Italia

Monday, 14 July 2025 02:51 UTC

La corte di appello di Stoccarda ha confermato che il Codice Urbani vale solo all’interno dell’Italia. Il codice Urbani è quello che afferma che un’opera anche fuori copyright perché vecchia di secoli può essere soggetta a “una tutela”; questo significa che se io voglio usare un’immagine dell’uomo vitruviano di Leonardo devo chiedere a chi gestisce l’immagine il permesso, e presumibilmente pagare per il diritto di usarlo. Bene: Ravenburger aveva prodotto un puzzle con l’uomo vitruviano, il ministero della Giustizia e le Gallerie dell’Accademia di Venezia hanno fatto causa, Ravensburger ha fatto una controcausa, e il risultato è che il puzzle può essere venduto tranquillamente al di fuori dell’Italia. La Corte non si è espressa sulla legalità del codice Urbani ripetto alla direttiva copyright, né poteva farlo; in pratica ha detto “non ci curiamo di cosa fate in Italia, affaracci vostri”.

Non credo che il nostro governo cambierà posizione: questo significa che noi italiani saremo cornuti e mazziati. Chissà se chiederanno anche di oscurare le immagini di Wikipedia se ci si connette dall’Italia…

Davvero tutte le foto sono artistiche?

Thursday, 22 May 2025 02:51 UTC

È in corso di discussione alla Camera la proposta di legge 2224, presentata da due deputati di Fratelli d’Italia e due di Forza Italia, avente titolo “Modifiche alla legge 22 aprile 1941, n. 633, in materia di tutela del diritto d’autore relativo alle fotografie”. Cosa dice questa proposta? Facciamo prima un passo indietro, e vediamo cosa dice attualmente la legge sul diritto d’autore.

Ci sono due tipi di tutela delle fotografie (il termine è da intendersi in senso molto lato: ovviamente non c’è più bisogno di avere pellicola o simili per avere una foto, pensate alle foto fatte con il furbofono). Da un lato ci sono le fotografie artistiche, dove si sottintende un atto di creatività del fotografo: queste fotografie sono equiparate ai libri, nel senso che hanno la stessa tutela (il copyright scade settant’anni dopo la morte dell’autore). Dall’altro ci sono le fotografie che non hanno creatività e sono semplicemente di tipo descrittivo: questa categoria comprende anche i singoli fotogrammi cinematografici e le foto di opere d’arte. Queste immagini hanno una protezione che dura vent’anni. La proposta di legge si occupa solo di quest’ultimo tipo di fotografie, e porta da venti a settanta anni la loro protezione. In altre parole, non potremmo per esempio usare per altri sette-otto anni una foto che mostra una strada cittadina nei primi anni ’60 per mostrare come i centri storici erano intasati dalle auto.

Ribadisco: stiamo parlando di foto che per definizione del legislatore non hanno alcuna creatività, che dovrebbe essere il concetto su cui si basa tutto il diritto d’autore. A questo punto mi sa che il prossimo passo sarà la tutela degli scatti automatici, perché si dirà che c’è comunque l’autorialità di chi ha posizionato la fotocamera in quel punto e poi ha definito l’algoritmo che decide il momento in cui la foto viene scattata…

Ma c’è una cosa ancora più ironica. L’unico motivo che io vedo alla base di questa proposta di legge è che qualcuno ritiene che in questo modo i fotografi potrebbero guadagnare tanti soldi con i diritti di queste foto, che adesso possono essere usati dopo vent’anni che non sono pochi ma nemmeno troppi: come ho detto, le foto creative sono già tutelate dalla legge. Bene. Pensateci un attimo. Stiamo parlando di foto puramente descrittive, senza nulla di artistico. Se io avessi bisogno di un’illustrazione di questo tipo e dovessi pagare per usarla, farei molto prima a generare un’immagine con l’intelligenza artificiale. Il fatto stesso che questa immagine è una mera descrizione elimina a priori i problemi di una possibile violazione di copyright, e in questo modo non solo non pago nessuno ma non devo neppure aggiungere una didascalia indicante l’autore. Non so che ne pensiate voi, ma per me una legge come questa sembra solo un boomerang.

Doxxing su Wikipedia

Monday, 10 February 2025 03:51 UTC

Leggo su Slate che la Heritage Foundation, il think tank americano che sta gestendo il famoso Project 2025 che tanto piace a Trump, vuole “identificare e prendere di mira” gli utenti di Wikipedia che secondo loro “abusano della loro posizione” su Wikipedia. Il motivo del contendere dovrebbe essere il fatto che quegli utenti sono filopalestinesi.

Non entro sulla neutralità o meno delle voci in questione, che non ho nemmeno guardato. Sono almeno quindici anni che affermo che Wikipedia non può dare la verità, ma al più la verificabilità di quello che scrive (e sì, lo so che a volte non riesce nemmeno a fare quello). Quello che è proccupante è l’intimidazione degli utenti. Come sapete, anche quando nell’enciclopedia non si scrive come anonimi quello che si legge come autore è solo il nickname scelto: nel mio caso per esempio io mi firmo “.mau.”, con scarsissima fantasia. Il nickname, oltre che essere figlio della cultura di rete degli anni ’90, serve anche nel caso di testi che potrebbero generare reazioni anche sulla persona: chi scrive su argomenti delicati potrebbe quindi decidere di farlo sotto pseudonimo, cosa che non dovrebbe nuocere a Wikipedia perché si immagina che le affermazioni inserite abbiano le fonti a supporto e altrimenti verrebbero tolte, nome vero o falso che abbiano.

Io indico esplicitamente sulla mia pagina utente il mio nome e cognome, ma io non scrivo su temi caldi. Inoltre io sono da così tanti anni in rete e ho scritto pubblicamente così tante cose che trovare informazioni su di me è banale, e comunque parto sempre dal principio che tutto quello che scrivo potrà essere usato contro di me, e quindi sto attento a quello che scrivo. Ma appunto non è troppo difficile trovare informazioni su qualunque persona scriva in rete, se si cerca con sufficiente sforzo: tutto questo è il doxxing, e ne vediamo esempi tutti i momenti. Anche nel nostro piccolo circola una lista di “veri nomi di amministratori di Wikipedia in italiano” (con alcuni errori), tanto per dire.

Il fatto è che il doxxing è MOLTO pericoloso, sicuramente molto più della boutade di Musk che offre un miliardo di dollari a Wikipedia se cambierà il nome in Dickopedia. (Poi uno si può chiedere perché rosica così tanto, ma la gente è spesso strana). Io preferisco una Wikipedia poco perfetta a una Wikipedia ingessata, anche se la Heritage Foundation avesse ragione sulla mancata imparzialità di quelle voci: si comincia così e non si sa mai dove si finisce, anzi lo si sa benissimo.

L’arte s’ha da pagare

Friday, 1 November 2024 03:51 UTC

l'aceto balsamico con l'immagine del duca d'Este Bisogna dire che i giudici italiani sono coerenti. Anche nella causa per l’uso non autorizzato dell’immagine del duca d’Este su un aceto balsamico, la corte d’appello di Bologna ha dato ragione al ministero della Cultura: non importa se le immagini sono di opere ovviamente fuori copyright, e non importa nemmeno se sono semplici immagini e non gli originali: se la vuoi usare per scopi commerciali, devi avere l’autorizzazione relativa (e immagino sganciare soldi, che ce n’è sempre bisogno). Per fortuna io non ho scopi commerciali né diretti né indiretti, quindi posso lasciare l’immagine incriminata.

Avrei forse capito se l’autorizzazione fosse necessaria per evitare usi distorti, anche se si potrebbe partire con una discussione sulla possibilità o meno di parodia. Ma non pare il caso, visto che si afferma che questi beni, una volta usati per lucro, perderebbero il loro valore come beni riconosciuti e protetti dalla legge. Ma questo, almeno a mio parere, dovrebbe allora valere anche per gli usi non a fini di lucro. Peggio ancora, il Codice dei Beni Culturali nasce (lo dice esso stesso) per “preservare la memoria della comunità nazionale e del suo territorio e promuovere lo sviluppo della cultura”, in accordo all’articolo 9 della Costituzione.

Continuo a pensare che se questa è l’idea del MiC almeno siano coerenti e vietino tutti gli usi pubblicitari del patrimonio culturale italiano, a partire dai loro. Mi chiedo solo quando qualcuno verrà a bloccare l’uso di quelle immagini su Wikipedia, visto che la licenza prevede il riuso commerciale e – fatto salvo per le opere fotografate per Wiki Loves Monuments – non mi pare proprio sia stata richiesta un’autorizzazione e qiundi non importa se quelle immagini sono solo per motivi di studio e ricerca.

Ci sono giornalisti e giornalisti

Sunday, 8 September 2024 17:03 UTC

L'IP che ha eliminato la data di morte di Schillaci Purtroppo pare che Totò Schillaci abbia avuto una recidiva del tumore al colon che l’aveva colpito. Purtroppo la mamma dei cretini è sempre incinta, e un utente anonimo oggi alle 15 aveva modificato la voce di Wikipedia sul protagonista di Italia 90, indicandone la morte. La falsa notizia è stata tolta un paio d’ore dopo da un altro utente anonimo, non prima che Repubblica scrivesse ” Addirittura il profilo di Wikipedia, come spesso accade, aveva proposto un aggiornamento di pessimo gusto annunciando la scomparsa nel 59enne proprio in data 8 settembre 2024.” (sì, la frase non ha senso: se il vandalo ha scritto oggi e l’articolo è di oggi, specificare la data non serve a nulla).

L’utente che ha inserito la morte di Schillaci è un siciliano non meglio identificabile, almeno con le informazioni pubbliche che io come tutti voi ho a disposizione. Invece si sa qualcosa di più dell’utente che ha tolto la data di morte, come potete vedere dall’immagine: si connetteva dalla sottorete pubblica del Messaggero, e presumibilmente è un giornalista. Per quel poco che può valere, voglio ringraziarlo pubblicamente.

Ultimo aggiornamento: 2024-09-08 19:03

Un’app per Wiki Loves Monuments Italia

Wednesday, 10 June 2020 22:29 UTC

Giocando con Appcelerator Titanium, un framework open source e rilasciato con licenza Apache per lo sviluppo di applicazioni mobile native a partire da una sola codebase, ho realizzato un’applicazione per il concorso Wiki Loves Monuments Italia. Trovate il codice sorgente su https://github.com/ferdi2005/monumenti.

In una settimana, è stato possibile implementare la possibilità di trovare monumenti tramite geolocalizzazione e mostrarli su una mappa, sia qualla di cercare una determinata località italiana (per esempio, Roma) e vedere i monumenti ivi presenti. In più, c’è anche una bellissima scheda per ogni monumento e un simpatico tasto refresh da premere quando ci si sposta, per esempio durante una wikigita.

La documentazione dell’API qui riportata è ferma a qualche versione fa per quanto riguarda il contenuto della risposta, ora c’è qualche parametro in più.

Backend

Ebbene, quando scrivi un’app mobile ti serve anche un backend! Ho deciso quindi di riutilizzare il mio progetto wlm.puglia.wiki ed ho esposto quindi alcune nuove simpatiche API in alcune delle nuove versioni. Quella piccola webapp prima aveva solamente la stessa funzione dell’app e dava la possibilità di trovare i monumenti vicino a sé con Leaflet + OSM, mentre ora svolge anche da backend dell’app. Per ragioni tecniche (non c’era un framework per Appcelerator Titanium), non ho potuto utilizzare OSM anche sull’applicazione mobile, quindi troverete su Android le mappe di Google e su iOS quelle di Apple, ma tutto il lavoro di geocoding è fatto da OSM, precisamente da Mapbox con OSM.

È stato duro anche trovare il modo di far funzionare l’URL di caricamento del monumento, che ora viene restituito insieme alle informazioni del monumento ed è generato miscelando informazioni dalla query SPARQL e dall’esecuzione tramite l’API parse di MediaWiki del Modulo:WLM su Wikipedia!

Trovare i monumenti

Il primo endpoint che ho messo a disposizione, un bel po’ di tempo fa già prefigurandomi l’app, è /monuments.json, che accetta come parametri sia latitude e longitude che city, per cercare invece i monumenti vicino ad una città.

La risposta è di questo tipo, il secondo array rappresenta il centro della mappa, cioé il punto al centro di tutti i risultati o, in caso di città, la localizzazione della città:

[[{"id":34746,"item":"Q61905499","wlmid":"16A6620042","latitude":"41.132779","longitude":"16.838713","itemlabel":"Non creiamo precedenti","image":null,"created_at":"2020-06-07T22:54:03.906Z","updated_at":"2020-06-07T22:54:03.906Z","itemDescription":"Scultura presso lo Stadio della Vittoria","distance":0.69212135568994,"bearing":"109.201534968318"}], [41.13698328712448,16.826640973289223]]

Più informazioni sul singolo monumento

A vostra disposizione c’è anche l’endpoint /show.json che accetta il parametro id corrispondente all’id del monumento che si ottiene attraverso la prima richiesta API. La risposta corrisponderebbe, visitando wlm.puglia.wiki/show.json?id=34746, a:

{"id":34746,"item":"Q61905499","wlmid":"16A6620042","latitude":"41.132779","longitude":"16.838713","itemlabel":"Non creiamo precedenti","image":null,"created_at":"2020-06-07T22:54:03.906Z","updated_at":"2020-06-07T22:54:03.906Z","itemDescription":"Scultura presso lo Stadio della Vittoria","distance":0.69212135568994,"bearing":"109.201534968318"}

Notare che gli ID cambiano ad ogni risincronizzazione del database e questo endpoint è stato creato esplicitamente per fornire le informazioni dall’app.

Indirizzo

Dato che il geocoding a quanto pare non funziona benissimo su iOS, ho predisposto un endpoint API del tipo /address.json che accetta il parametro id, sempre corrispondente all’id del monumento ottenuto sempre nel primo endpoint.

Per esempio wlm.puglia.wiki/address.json?id=34746 risponde:

Piazzale Vittorio Emanuele Orlando, Bari, Bari, 70132, Italy

Ringraziamenti

Siamo ormai giunti alla versione 1.1.3. 😁 Per il raggiungimento di questo risultato mi preme ringraziare i miei fidi beta tester anticipati Yacine Boussoufa e Stupeficium, ma anche il carissimo sviluppatore Titanium Michael Gangolf, che mi ha dato alcuni importanti consigli per l’applicazione

Download

Siete convinti adesso? Mentre risolvo i problemi con la burocrazia per pubblicare su iOS (magari ottenendo lo sconto della quota per il no profit), vi lascio i link per scaricare l’applicazione su Android. Notate che per utilizzare l’app è necessario avere i Google Play Services attivi.

Non dimenticate di lasciare una recensione o un commento, o di scrivermi se avete qualche dubbio!

Giù le mani da Wikipedia

Tuesday, 7 April 2020 18:09 UTC

Repubblica oggi ritorna sulle minacce di morte arrivate domenica via Twitter a Carlo Verdelli in maniera peculiare. Cito dall’articolo:

L’ultima minaccia è, se possibile, ancora più inquietante delle precedenti. Mostra lo screenshot della pagina Wikipedia relativa a Carlo Verdelli, manipolata da una mano ignota. Accanto alla data di nascita, è stata inserita quella di morte: 23 aprile 2020. E la sintesi della bio recita: “È stato un giornalista italiano, direttore del quotidiano la Repubblica”. Declinata al passato. E rilanciata su Twitter da un profilo anonimo che, nonostante le segnalazioni, risulta tuttora attivo e vomitante insulti.

(per la cronaca, oggi pomeriggio quell’account Twitter era stato cancellato). Qualcuno, leggendo l’articolo, avrà sicuramente pensato che la persona in questione aveva modificato la voce dell’enciclopedia per poi fare la schermata e pubblicarla. Bene, non è successo nulla di tutto questo, come potete vedere voi stessi guardando la pagina con l’elenco delle modifiche sulla voce. Per i curiosi, è possibile per i sysop cancellare versioni della voce che contengano insulti o bestemmie, in modo che sia impossibile vedere cosa c’è scritto: ma l’esistenza di una modifica rimane comunque visibile, con la modifica in questione con una riga sopra (strikethrough) per ricordare che qualcosa c’era stato.

Image
Giulio Cesare è ancora vivo e lotta insieme a noi!

Una volta i più ingenui detrattori di Wikipedia facevano una modifica, scattavano l’immagine e poi si lanciavano a denunciare gli errori dell’enciclopedia — errori che magari erano stati corretti un paio di minuti dopo, alle due del mattino. Ora evidentemente queste persone si sono un po’ più evolute, e hanno scoperto come creare una voce fasulla senza lasciare nessuna traccia. Ci ho provato io, e in cinque minuti ho prodotto uno screenshot simile a quello ora non più visibile: solo che mi sembrava macabro far morire qualcuno e ho preferito rendere ancora vivo Giulio Cesare, come vedete qui sopra. Segnalo anche ai giornalisti di Repubblica che leggere la voce del loro direttore “declinata al passato” è un semplice sottoprodotto dell’avere inserito una data di morte; avendola io tolta dalla voce sul Divus Iulius, essa è magicamente passata al presente.

Detto in altri termini, quello che è successo è l’equivalente di una busta contenente un proiettile e recapitata con la posta; con il lockdown probabilmente è in effetti più semplice mettersi al computer e falsificare una schermata. Al massimo si può chiedere alla Polizia postale di andare dal signor Twitter e chiedere i dati sulla connessione dell’utente che aveva postato lo screenshot, dati che immagino non verranno consegnati, ma nulla di più. Eppure, leggendo l’articolo, Twitter pare semplicemente essere un complice neppure tanto importante del vero sito perpetratore, il che la dice lunga sulla capacità di “leggere” un testo in rete.

(Per la cronaca, che io sappia non è stato chiesto a nessun esperto wikipediano cosa poteva essere successo. Eppure a me continuano ad arrivare richieste di persone che pretendono che io aggiusti un danno fatto a loro su Wikipedia… Si vede che non ne valeva la pena).

Image

Scrittura collettiva a Barbiana

Thursday, 13 February 2020 11:59 UTC

Lettera ad una professoressa fu scritto collettivamente, dall’intera Scuola di Barbiana di Don Milani – e, infatti, è proprio la Scuola intera l’autore che firma il libretto.

Noi dunque si fa così: per prima cosa ognuno tiene in tasca un notes. Ogni volta che gli viene un’idea ne prende appunto. Ogni idea su un foglietto separato e scritto da una parte sola. Un giorno si mettono insieme tutti i foglietti su un grande tavolo. Si passano uno a uno per scartare i doppioni. Poi si riuniscono i foglietti imparentati in grandi monti e son capitoli. Ogni capitolo si divide in monticini e son paragrafi. Ora si prova a dare un nome ad ogni paragrafo. Se non si riesce vuol dire che non contiene nulla o che contiene troppe cose. Qualche paragrafo sparisce, qualcuno diventa due. Coi nomi dei paragrafi si discute l’ordine logico finché nasce uno schema. Con lo schema si riordinano i monticini. Si prende il primo, si stendono sul tavolo i foglietti e se ne trova l’ordine. Ora si butta giù il testo come viene viene. Si ciclostila per averlo davanti tutti eguale. Poi forbici, colla e matite colorate. Si butta tutto all’aria. Si aggiungono foglietti nuovi. Si ciclostila un’altra volta. Comincia la gara a chi scopre parole da legare, aggettivi di troppo, ripetizioni, bugie, parole difficili, frasi troppo lunghe, due concetti in una frase sola.
Si chiama un estraneo dopo l’altro. Si bada che non siano stati troppo a scuola. Gli si fa leggere a alta voce. Si guarda se hanno inteso quello che volevamo dire. Si accettano i loro consigli purché siano per la chiarezza. Si rifiutano i consigli di prudenza.

Wikipedia “before it was cool”, nel 1967.

È proprio l’algoritmo a essere impazzito?

Sunday, 22 September 2019 16:26 UTC

Certo, gli algoritmi possono essere scritti male e dare risultati del tutto sbagliati e perniciosi.. Ma proviamo a non personificarli.

Scuola, trasferimenti di 10mila docenti lontano da casa. Il Tar: L’algoritmo impazzito fu contro la Costituzione”
eh sì, povera Costituzione…

La colpa? È come al solito “dell’algoritmo impazzito”. Così scrive la Repubblica raccontando dell’ultima sentenza del Tar del Lazio a riguardo dell’assegnazione delle cattedre ai vincitori del concorso scolastico nel 2016. A dire il vero non sono riuscito a trovare il testo della sentenza (per i curiosi, dovrebbe essere la 06606/2019 della terza sezione bis del Tar del Lazio), e la mia sensazione è che in realtà quello scritto da Repubblica sia una silloge di varie sentenze sul tema, visto che la sentenza principale arriva a fine maggio. Ma non è questo il punto importante: quello che mi preoccupa è leggere affermazioni, presumo scritte da periti (cioè “esperti”), che non stanno né in cielo né in terra. Ecco alcune di queste affermazioni con i miei commenti. Una precisazione: io sono convinto che quell’algoritmo fosse malfatto. Ma sono anche certo che le ragioni addotte per cassarlo giuridicamente non abbiano senso. Vediamo come alcune delle frasi riportate da Key4biz — che sono prese da una sentenza precedente, la n. 9224/2018 che deve semplicemente essere stata confermata da quest’ultima — vengono lette da chi ha un po’ di conoscenza del tema. Cominciamo subito:

“[…] un procedimento amministrativo, ancorché difficile o complicato, non può essere devoluto ad un “meccanismo informatico o matematico del tutto impersonale e orfano di capacità valutazionali delle singole fattispecie concrete, tipiche invece della tradizionale e garantistica istruttoria procedimentale che deve informare l’attività amministrativa, specie ove sfociante in atti provvedimentali incisivi di posizioni giuridiche soggettive di soggetti privati e di conseguenziali ovvie ricadute anche sugli apparati e gli assetti della pubblica amministrazione.”

Traduciamo dal burocratese (particolarmente pesante, come capita spesso quando non si vuole che traspaia il vero significato): occorre che qualcuno decida il risultato finale. Se siamo buoni, potremmo pensare a una verifica che sia andato tutto bene: questo è sicuramente qualcosa che deve essere fatto, ma dubito che in quel caso fosse davvero fattibile. Spero che non ci sia il retropensiero “se ci sono delle persone che controllano, loro possono aggiustare quello che serve”. Ma pensateci: cosa diavolo sarebbero le “capacità valutazionali delle singole fattispecie concrete”? Detto in altri termini, quali sono le valutazioni che non possono proprio essere fatte da un algoritmo ma necessitano un giudizio umano? E in effetti, continuando a leggere, troviamo

“un algoritmo, quantunque, preimpostato in guisa da tener conto di posizioni personali, di titoli e punteggi, giammai può assicurare la salvaguardia delle guarentigie procedimentali che gli artt. 2, 6,7,8,9,10 della legge 7.8.1990 n. 241 hanno apprestato, tra l’altro in recepimento di un inveterato percorso giurisprudenziale e dottrinario…. gli istituti di partecipazione, di trasparenza e di accesso, in sintesi, di relazione del privato con i pubblici poteri non possono essere legittimamente mortificati e compressi soppiantando l’attività umana con quella impersonale, che poi non è attività, ossia prodotto delle azioni dell’uomo, che può essere svolta in applicazione di regole o procedure informatiche o matematiche. […]”

Beh, sì: un algoritmo farebbe molta fatica a leggere un testo del genere, mi sa. Ma non capisco quali siano i problemi per cui un algoritmo non possa assicurare la partecipazione (vengono eliminati a priori tutti quelli che non hanno un R nel loro cognome?), trasparenza (non vengono elencati i punteggi ottenuti dai vari candidati?) e l’accesso (ci vuole una password per vedere i risultati?). Ma proseguiamo.

“non è conforme [alla Costituzione e alla legge sulla semplificazione normativa] […] affidare all’attivazione di meccanismi e sistemi informatici e al conseguente loro impersonale funzionamento, il dipanarsi di procedimenti amministrativi, sovente incidenti su interessi, se non diritti, di rilievo costituzionale, che invece postulano, onde approdare al corretto esito provvedimentale conclusivo, il disimpegno di attività istruttoria, acquisitiva di rappresentazioni di circostanze di fatto e situazioni personali degli interessati destinatari del provvedimento finale, attività, talora ponderativa e comparativa di interessi e conseguentemente necessariamente motivazionale, che solo l’opera e l’attività dianoetica dell’uomo può svolgere.”

Lo confesso. Ho dovuto aprire il De Mauro per scoprire cosa significasse “dianoetico”. Cosa volete, Ron Hubbard non mi ha mai detto molto. Ad ogni buon conto, il De Mauro snocciola “agg. TS filos. — discorsivo, razionale”. Insomma, l’essere umano è un animale razionale, lo diceva già Aristotele; l’algoritmo no, e infatti Aristotele nulla affermò al riguardo. Ma poi quali sarebbero le “situazioni personali” di cui si parla? Un banale “tengo famiglia”? Offerte che non si possono rifiutare? Una consapevolezza olistica? Io ero convinto che — pur con tutte le difficoltà oggettive possibili — un concorso dovrebbe essere il più asettico possibile, perché si cercano le persone migliori. Invece a quanto pare non è così. Il “funzionario persona fisica […] deve seguitare ad essere il dominus del procedimento stesso”. Qui in realtà c’è il primo punto condivisibile della sentenza: il funzionario-dominus infatti deve operare

“all’uopo dominando le stesse procedure informatiche predisposte in funzione servente e alle quali va dunque riservato tutt’oggi un ruolo strumentale e meramente ausiliario in seno al procedimento amministrativo e giammai dominante o surrogatorio dell’attività dell’uomo.”

Su questo invece non c’è nulla da eccepire, a parte l’ampollosità della prosa. Se tu, umano funzionario, non capisci un tubo di come funziona l’algoritmo che stai usando allora non stai facendo bene il tuo lavoro. Qui si apre un mondo totalmente diverso, però! Non entriamo nel merito degli algoritmi di deep learning il cui funzionamento dettagliato è inconoscibile persino da chi li ha sviluppati, e per cui ci vorrebbe un saggio a parte. Il caso in questione è infatti molto più semplice, per fortuna, e si suppone che l’umano funzionario, in qualità di animale ragionevole, possa comprendere il funzionamento dell’algoritmo. Se non ci riesce di chi è la colpa? Il tutto naturalmente a meno che il suddetto non debba semplicemente verificare a mano che le decine di migliaia di vincitori fossero stati assegnati ai posti corretti, a meno che non si chiami Marco Bussetti. Beh, no, questa è cattiveria. Se leggete l’intervista vedete che Bussetti ha dato gli onori a una funzionaria del ministero.

Ma seriamente il punto è un altro. Se la storia raccontata dall’ex ministro è vera, che l’algoritmo fosse bacato era evidente a chiunque, e pertanto bene ha fatto il Tar ad annullare i risultati della procedura e stigmatizzare chi ha preso i risultati e li ha inviati senza nemmeno dare loro un’occhiata. E non poteva allora dire semplicemente questo? Evidentemente no. Occorreva personificare l’algoritmo in modo da dare la colpa, o almeno un concorso di colpa, ad esso. Perché sono gli algoritmi a impazzire, non i programmatori che non li sanno scrivere e correggere o i funzionari che non hanno voglia di vedere cosa è successo. Troppo facile così. Alla fine è più onesta la chiusa dell’articolo di Repubblica: «A questo baco [dell’algoritmo che premiava la geografia] si sarebbero aggiunti, poi, diversi errori nell’immissione dei dati. Errori umani, non solo orwelliani.» Appunto. È troppo facile nascondersi dietro l’algoritmo per non tirare fuori le vere colpe, in questo caso di chi l’ha scritto e di chi (non) l’ha testato…

Image

Alessandro Baricco e il suo Game

Wednesday, 29 May 2019 02:16 UTC

Uno sguardo molto personale alla filosofia di Baricco nascosta all’interno del suo ultimo saggio

Image
Baricco avrà cominciato a giocare a Space Invaders, io sono più anzyano e parto da Pong. (Immagine: Wikimedia Commons, File:Pong.png)

Ho deciso di leggere l’ultimo libro di Baricco. Avevo saltato I barbari, esattamente come ho saltato tutta la sua produzione editoriale. In realtà leggevo la rubrica che teneva sulla Stampa qualche decennio fa, e ai tempi avevo stabilito che mi era bastata questa esposizione. Succede però che il tema di The Game si intreccia con altre cose su cui sto cercando di trovare una quadra. È vero che “ars longa, vita brevis”, come diceva (in greco) Ippocrate e dice (in latino) Douglas Hofstadter; però è anche vero che non è bello eliminare pregiudizialmente qualcosa, e quindi ho pensato di dedicare qualche ora della mia vita a vedere come Baricco ha voluto trattare il tema. (Spoiler: pensavo molto peggio. Non consiglierei il libro come unica voce in capitolo, ma vale la pena di leggerlo se si ha già un’idea di quello di cui si parla: se lo si prende senza preconcetti, si scopre che non tutto quello che diamo per scontato è vero).

Qui però non voglio parlare tanto del contenuto del libro — una mia recensione più o meno decente la trovate qua — quanto piuttosto della “baricchitudine”. Mi interessa insomma raccontare come io ho decodificato il suo pensiero, perché ci sono varie cose che secondo me rimangono nascoste. Per prima cosa, Baricco scrive dannatamente bene. Su questo non c’è storia. Le sue frasi si snocciolano senza sforzo, e il lettore plana amabilmente su di esse senza sforzo alcuno. (Sono molto invidioso, sì). Questo è bellissimo, ma nel caso di un saggio c’è un piccolo problema: il lettore in questione si beve tutto senza porsi alcuna domanda sulla verità di quanto scritto. Come sappiamo bene, una bugia ben proposta funziona meglio di una verità nuda e cruda. Sto dicendo che Baricco ha scritto una serie di fregnacce? No. Ne ha scritte, intendiamoci: ma andando avanti nella lettura mi sono accorto che spesso — qualche decina di pagine dopo quello che avevo rubricato come cazzata — Baricco scriveva esattamente l’opposto. L’idea che mi sono fatto è che è una palla che lui abbia scritto il libro buttando giù man mano il testo. Lì dietro c’è un lavoraccio, e la cosa mi fa incavolare ancora di più, perché sono convinto che lui abbia messo apposta buona parte degli erroracci per far fare al lettore il giro che lui voleva. Non è bello. Verso la fine lo ammette anche tra le righe, anche se non ha il coraggio di dire che i primi due capitoli sono in buona parte fregnacce e se ne esce con “è preistoria” con il consiglio di non rileggere quel testo.

Baricco è un filosofo: quindi per lui il Game ha una filosofia sottostante. Io non sono filosofo e anzi sono sempre stato una capra in filosofia: però non mi bevo il suo professarsi cartesiano con tanto di esempi, e preferisco fermarmi alla lettera. Il Game è Movimento — lo dice lui — quindi è eracliteo. Il problema è che se si parte da questo assunto occorre portarlo avanti coerentemente, cosa che Baricco del resto fa. Questo va benissimo quando concludi che la caratteristica fondamentale di questi “oltremondi” digitali sia la velocità e la leggerezza, che fanno portare a galla l’essenza delle cose anziché nasconderla in fondo come fa il nostro mondo analogico. (“Analogico” e “digitale” sono traduzioni mie, Baricco non usa mai questa terminologia, e anche questo secondo me è un segno: vuole spostare il terreno di gioco, e per farlo coglie una caratteristica diversa da quella tipicamente usata. Ottima mossa, perché costringe il lettore a rivedere tutti i suoi pre-giudizi). Questo però va molto meno bene quando decide di rinominare la post-verità “verità-veloce”, definendola come «una verità che per salire alla superficie del mondo — cioè per diventare comprensibile ai piú e per essere rilevata dall’attenzione della gente — si ridisegna in modo aerodinamico perdendo per strada esattezza e precisione e guadagnando però in sintesi e velocità». Baricco scrive molto meglio di me, ma il concetto è lo stesso che ho scritto nel capoverso precedente: «una bugia ben proposta funziona meglio di una verità nuda e cruda». L’esempio che fa, quello dei “vinili che hanno venduto più del digitale”, è paradigmatico: usa varie pagine per mostrare come quell’affermazione sia l’equivalente delle barzellette su Radio Erevan, perché quello che è successo è che nel Regno Unito in una specifica settimana le vendite di vinile hanno superato il fatturato della pubblicità collegata al download gratuito in digitale, e conclude che sì, la frase non rappresenta i fatti, ma permette però di scoprire tante cose. Palle. Le cose le scopri solo se stai ancora pensando come una persona pre-Game e vai a sfrucugliare. Anche la sua affermazione che in fin dei conti il termine “post-truth” esisteva già nei casi delle armi di distruzione di massa di Saddam Hussein e nel doping di Armstrong non funziona: nel secondo caso non è nemmeno post-verità ma semplice negazione, e ai tempi della scenetta di Colin Powell il termine era stato usato una sola volta dieci anni prima in un libro che non era stato filato praticamente da nessuno. (Il secondo libro, che aveva anche il termine nel titolo, uscì l’anno successivo, e fu comunque filato poco).

Questa difesa baricchiana della post-verità, che funziona indipendentemente dai fatti, ha ovviamente una sua origine ben precisa, che si riassume in una parola: narrazione. (“Storytelling”, se siete molto anglofoni. Però questo è uno dei pochi casi in cui il termine italiano è riuscito a mantenere una certa qual forza). Baricco è un campione di narrazione, per negarlo occorre avere davvero una bella faccia tosta. Ha anche ragione quando afferma che non è necessario partire dai fatti per ottenere una bella narrazione: millenni di epica dovrebbero averlo reso chiaro. Però non può incrociare i flussi e applicare al mondo gli stessi schemi di un oltremondo ante litteram qual è la narrativa! Ok, l’ha fatto, e sono ragionevolmente certo che giocasse sul fatto che non se ne sarebbe accorto nessuno, né tra i suoi fan che si sarebbero bevuti tutto né tra i detrattori che invece l’avrebbero stroncato a priori e quindi senza un vero confronto sul testo. Ecco: forse questa sì che è verità-veloce!

Un’ultima nota, tecnica ma anche personale. Baricco ha cinque anni più di me, quindi siamo praticamente della stessa generazione. Però abbiamo vissuto una vita diversissima. È vero che io non sono un nativo digitale, ma sono attaccato a una tastiera da quando avevo quindici anni: faccio quasi parte del gruppo dei pionieri del digitale — attenzione: non dell’élite di cui lui parla: al più, esagerando, dei tecnici nascosti dietro le quinte . Baricco ha fatto un bel lavoro per entrare “da vecchio” nell’oltremondo: ma qualcosa rimane sempre. Ho sorriso quando ho letto «È la postura in cui sto scrivendo questo libro. [Non quella in cui, probabilmente, lo state leggendo: onore al libro cartaceo, che ancora resiste a qualsiasi mutazione].» Stavo naturalmente leggendo il libro nella postura uomo-schermo, quello del furbofono dove ho la copia in formato ePub. Possiamo poi dibattere se la versione elettronica di questo libro sia o no una mutazione e se le note che ho preso sullo smartphone siano la stessa cosa di quelle che una volta si scrivevano a matita sulle pagine: però quell’inciso è la prova che forse non tutto è ancora così liscio come lui cerca di convincerci…

Image

È sempre colpa di Wikipedia

Thursday, 16 May 2019 10:58 UTC

Per esempio, Wikipedia non spiega che informazione e conoscenza sono due cose distinte.

Image
Informazione e conoscenza non sono necessariamente correlate (da https://en.wikipedia.org/wiki/File:DIKW_(1).png )

Grazie (?) ad Antonio Pavolini ho scoperto questo articolo di Linkiesta: «La generazione Wikipedia è ignorante. E vota politici ignoranti». Occhei: solito titolo acchiappaclic che poi viene declinato nel corpo dell’articolo con l’ormai onnipresente effetto Dunning-Kruger e la citazione di Wikipedia come simbolo del male. Di per sé nulla per cui varrebbe la pena passare una mezz’oretta a scrivere un commento, nemmeno per rimarcare come con ogni probabilità la gente non guardi nemmeno Wikipedia per farsi la propria opinione totale definitiva, ma prenda qualcosa di orecchiato qua e là. Come dicevo sopra, la parola “Wikipedia” è semplicemente usata come acchiappaclic.

C’è però un passaggio dell’articolo che a mio parere è molto più interessante per comprendere come l’intelligencija si ponga davanti alla cultura. Cito:

Sono questi gli effetti, anch’essi paradossali, dell’età dei social e di Wikipedia. La disponibilità immediata di informazioni a vantaggio di chiunque non ha portato, come si credeva, a un generale accrescimento della cultura e della capacità critica. Al contrario, ha favorito il conformismo e la chiusura intellettuale e ha reso disponibile non una conoscenza diffusa ma una nociva infarinatura un tanto al kilo.

Ecco. Una frase come quella mostra un fraintendimento tipico, di cui ho scritto con Paolo Artuso nel nostro Scimmie digitali. Perché mai avere più informazione dovrebbe portare a una maggiore cultura? Se la cosa vi pare sensata, provate a pensare alla quantità di informazione contenuta nei computer. Direste forse che essi siano acculturati? La piramide DIKW spiega molto bene il concetto. La conoscenza si basa sull’informazione, ma è separata da essa. Le informazioni sono i mattoni che noi dobbiamo prendere e assemblare per formare la nostra “casa della conoscenza”, più o meno sgarrupata a seconda delle nostre capacità e del materiale che troviamo. Ma i mattoni da soli non bastano: come minimo ci vuole della malta per tenerli insieme. Fuori di metafora, la malta è la nostra materia grigia che deve essere messa in moto per comprendere le informazioni che vediamo, confrontandole magari tra di loro per avere un’idea di quali probabilmente sono errate — per tutta una serie di ragioni, dal basarsi su dati errati all’essere state create apposta per confondere. Naturalmente azionare la materia grigia è sempre un’operazione costosa: semplicemente un tempo si tendeva a essere conformisti seguendo quello che diceva il prete o il segretario del partito, mentre adesso ci sono più conformismi tra i quali scegliere… no, il verbo “scegliere” non funziona bene, perché richiede comunque fatica. Meglio “prenderne uno”.

Quello che forse potremmo dire è un’altra cosa: che la generazione Wikipedia pensa di dover avere una propria opinione su tutto, cosa che in effetti in passato non capitava, o almeno non capitava pubblicamente. Ma anche su questo io ho dei dubbi. Mi pare che più che esprimere opinioni ci si limiti a rilanciare pedissequamente quello che si trova in giro e piace, dai gattini agli insulti contro Laura Boldrini, dalle frasi leziose in stile Baci Perugina alla foto della prima pagina del libro su Matteo Salvini. Non parlerei nemmeno di infarinatura di conoscenza, insomma: non si sta superando il livello “conoscenza”. Io sono pessimista e temo che dovremo convivere con questo nuovo modo di agire, ma in ogni caso la disponibilità o meno di informazioni è irrilevante in questo contesto. Cultura capacità critica, se proprio le volete, ve le dovete gestire da voi.

P.S.: L’articolo originale di Justin Kruger e David Dunning è del 1999: prima che nascesse Wikipedia, ma soprattutto prima che Internet diventasse così pervasiva. Non diamo proprio tutte le colpe alla rete.

Image

Un applauso ad Axel Voss

Wednesday, 27 March 2019 21:34 UTC
Image

Facciamo tutti un applauso al nostro caro amico Axel Voss (su forza, vi voglio sentire forte), che dopo anni di lavoro, ieri è riuscito a far approvare la sua tanto sognata direttiva sul diritto d’autore nel mercato unico digitale europeo!

Gli intenti della riforma non sono così malvagi: aveva lo scopo di riordinare il diritto d’autore in modo uniforme in tutta Europa, che però è stato già mancato perché si tratta di una direttiva e non regolamento, soggetta all’interpretazione dei singoli stati, che cambierà irrimediabilmente qualche cosa (piccola o grande) rispetto ai contenuti iniziali.

Wikipedia si è oscurata ben due volte contro la riforma, ma è servito solo a sensibilizzare l’opinione pubblica, perché il vero problema di questa riforma sono gli articoli 11 e 13 (ora hanno cambiato numerazione, ma non è importante). Wikipedia potrebbe esserne anche esclusa, ma il problema è costituito proprio dal contenuto di questi articoli. 

L’art. 13 parla di censura coff coff filtro preventivo per la verifica delle violazioni di copyright sulle piattaforme che contengono materiali caricati dagli utenti (in pratica è stata fatta per colpire Youtube, ma dato che Youtube questo tipo di filtro ce l’ha già e comunque non ha problemi a procurarsene uno, andrà a colpire solamente i provider più piccoli che non hanno a disposizione questo tipo di sistemi).

L’articolo da cui non si salva nessuno, neanche Wikipedia, è l’11. Non sono ancora riuscito a capire come abbiano fatto a sognarsi un’idiozia del genere, eppure siamo qui a discuterne, purtroppo. L’art. 13 parla di “link tax” e mira, praticamente, a chiedere una tassa ai servizi come Google News, pretendendo un pagamento per i piccoli, brevi estratti degli articoli giornalistici che vengono visualizzati. Ovviamente Google ci guadagna miliardi di miliardi di miliardi di euro su quei brevi snippet. Sono così tanti i soldi che guadagna che ha già chiuso Google News in Spagna (a causa di una legge simile approvata qualche tempo fa dal parlamento spagnolo) e spero che lo chiuda in tutta Europa, in modo che le lobby dell’editoria che hanno voluto questa riforma (perché, non illudiamoci, pressione c’è stata da entrambe le parti) possano raggiungere il loro scopo ed invece di riempirsi le tasche, si ritrovino con il -60% di visualizzazioni dei loro articoli. 

Ciò che spetta ai creatori dei contenuti deve essere assolutamente versato, ma questa è un’esagerazione da cui (al massimo, ma credo proprio no) guadagneranno pochi e guadagneranno poco, per perderci tutti insieme. 

Io ho già i popcorn pronti.


Che poi, dicono mercato unico digitale europeo, ma internet è mondiale…

Wiki Loves Monuments in Chiesa

Friday, 22 February 2019 18:21 UTC

Qualcuno (e ho in mente anche qualche nome) starà storcendo il naso leggendo questo titolo. Invece, è proprio così, la mostra di Wiki Loves Monuments ha fatto tappa presso la parrocchia Santissimo Sacramento di Bari.

Image

I ragazzi della parrocchia hanno fatto un lavoro splendido: non solo hanno allestito i pannelli senza chiedere nessun aiuto, ma hanno partecipato all’incontro di presentazione della mostra dimostrando di essere molto interessati all’argomento.

L’incontro è servito a due cose. La prima parte è stata dedicata a Wiki Loves Monuments, la seconda invece sul lato più morale che c’è dietro la filosofia dei progetti Wiki, parlando anche del valore del sentimento cristiano della condivisione che si può ritrovare in Wikipedia. Ha partecipato anche l’assessora alle politiche giovanili Paola Romano.

Il web non è cattivo. Internet ha usi buoni ed usi cattivi. Uno di questi usi, all’insegna della condivisione con gli altri, è Wikipedia e porta davvero giovamento a tutti. Il valore del tempo che si usa sul web è determinato da cosa effettivamente si fa e si possono fare cose molto cattive e molto buone.

Assessora Paola Romano

Tutto si è chiuso con una visita alla mostra, anche da parte dei parrocchiani, e la promessa di organizzare a Marzo un corso su Wikipedia per i ragazzi dalla 2ª media in poi. Non trovate che sia stupendo quando mondi che possono sembrare lontani si intrecciano?

Bari aderisce a Wiki Loves Monuments

Sunday, 17 February 2019 11:43 UTC

Nuntio vobis gaudium magnum, da febbraio 2019 l’amministrazione comunale cittadina aderirà al concorso Wiki Loves Monuments, rilasciando un’autorizzazione come previsto dal Codice dei Beni Culturali.

Sono tanti i monumenti che non possono partecipare al concorso a causa di queste limitazioni burocratiche. Da oggi, però, ci sono sessanta monumenti partecipanti in più. Eh, già! Mi toccherà inserire su Wikidata, il progetto che ospita i dati dei monumenti partecipanti e non al concorso, tutte le statue, i busti e gli altri tipi di monumenti censiti dal comune di Bari all’interno della catalogazione generale, andando ad individuare le coordinate e spesso anche l’indirizzo preciso di ogni singolo monumento.

Questi sacrifici però si possono fare, perché dal 2019 consentiranno alle bellezze della nostra città di essere diffuse nel mondo o almeno durante le mostre itineranti con il premio locale Puglia 😀

Speriamo anche che servano a convincere quelle cape toste (non è latino ma dialetto barese) del Polo Museale della Puglia a partecipare a questa bellissima iniziativa che dal 2012 diffonde il patrimonio culturale italiano a livello internazionale.

Nel frattempo il buon Afnecors ha disegnato il nuovo logo di Wiki Loves Puglia.

Direttiva europea sul copyright: fatti e opinioni

Tuesday, 10 July 2018 19:12 UTC

Smontiamo un po’ di luoghi comuni

Image
Copywrong, di GDJ — https://openclipart.org/detail/219802

Ora è terminato tutto il cancan sulla votazione all’Europarlamento per decidere se la direttiva per il copyright sul mercato unico digitale era a posto così e pronta per il trilogo, oppure sarebbe stato opportuno discuterla in plenaria. È arrivato forse il momento di mettere qualche puntino sulle i, presentando i temi del contendere in modo spero chiaro. Ho scelto esplicitamente di separare la prima parte (i fatti, scritti nel modo più neurto possibile) dalle mie opinioni, che sono personali e non necessariamente condivisibili. In questo modo spero possiate farvi un’idea un po’ più chiara dei temi della contesa.

Cominciamo da una premessa, anzi due. È doveroso che il lavoro creativo sia giustamente rimunerato: nessuno tra coloro che hanno espresso il loro parere contrario alla direttiva afferma che si può copiare liberamente materiale prodotto da altri senza il loro esplicito permesso (ed eventualmente pagando i diritti d’autore: sono due cose distinte). In generale, quando parliamo di copyright ammettiamo implicitamente che ci debba essere stato lavoro creativo. Ricordo però che almeno in Italia gli autori non hanno quasi mai il copyright sulle proprie opere. Se non ci credete, prendete un libro, un disco o un film e vedete cosa c’è scritto vicino alla ©. Naturalmente il titolare dei diritti (quello dopo il ©, appunto) paga l’autore per avere il diritto di pubblicare l’opera: sono le royalties, il compenso per la cessione dei diritti economici d’autore (per la legge italiana, i diritti morali — vale a dire la cosiddetta proprietà intellettuale — è inalienabile). E anche nel caso in cui i diritti siano pagati a forfait una volta per tutte e non in percentuale sugli acquisti, è vero che se l’editore non guadagna abbastanza poi non potrà più pubblicare; quindi in futuro ci perderà anche l’autore. Ricordiamoci però che non è vero che il copyright è degli autori. Ah: ricordiamoci anche che “copyright” è una parola ombrello, e ci sono tantissimi diritti, economici e no, che possono essere gestiti ognuno separatamente. In Italia per esempio il diritto morale — quello che dice “quest’opera è mia” — è inalienabile: la proprietà intellettuale rimane a te e basta. Invece in teoria uno potrebbe cedere a un editore i diritti per la pubblicazione della propria opera in versione cartacea ma non elettronica, oppure tenersi quelli per un’eventuale trasposizione cinematografica o teatrale (tecnicamente “opere derivate”; anche la traduzione lo è, il che significa che non si può tradurre un libro senza che il detentore dei diritti sia d’accordo).

Passando agli articoli della direttiva, notiamo che rispetto alla sua formulazione iniziale è stata rimossa l’eliminazione di un diritto di copyright. Il cosiddetto diritto di panorama dà la possibilità a tutti (e quindi toglie al creatore dell’opera il copyright relativo) di fotografare monumenti e palazzi sulla pubblica via e fare un uso commerciale di queste foto (gli usi personali erane già ammessi). Ora il diritto di panorama è possibile solo in alcune nazioni europee — l’Italia non è uno di questi; inizialmente era stato concesso, nel testo finale non se ne parla piú. L’articolo 11 invece aggiunge un nuovo diritto di copyright (“ancillary copyright”). Lo spirito della direttiva è che un aggregatore di notizie (si prendono titolo e un pezzetto di testo su un certo tema da più fonti) cadrebbe sotto il copyright di chi ha scritto le notizie originali, anche se ciascuno dei vari pezzi può essere usato singolarmente per il diritto di citazione. In informatica esiste già qualcosa di simile, i diritti sulle basi di dati, cioè sul lavoro fatto da chi ha messo insieme un certo numero di informazioni in modo creativo. Ricordo comunque che gli articoli presenti nell’aggregatore non possono già ora contenere il testo originale completo o comunque oltre il diritto di citazione perché in tal caso si violerebbe il copyright, e che il semplice hyperlink — la stringa che comincia con http:// e che una volta cliccata porta al sito remoto — sarebbe rimasto liberamente usabile. Infine l’articolo 13 non modifica la normativa sul copyright: ciò che è lecito o vietato continuerebbe a esserlo allo stesso modo. Quello che cambia è il modo in cui il copyright viene verificato. Ora lo è a posteriori: se io titolare di copyright trovo che tu sito hai un’opera sotto copyright ti ordino di toglierla. Con la direttiva sarebbe stato per default a priori: chi riceve dei contenuti deve verificare preventivamente che non siano sotto copyright, stringendo accordi con i vari detentori di diritti. La regola avrebbe previsto varie eccezioni, tra cui Wikipedia e GitHub, anche se la sua formulazione non era così chiara: Wikipedia è sì un progetto non-for-profit ma permette l’uso commerciale del materiale in essa contenuto, e quindi non è detto che l’eccezione sarebbe stata valida.

Fin qui i fatti. Spero che su di essi possiamo tutti essere d’accordo. Da qui in poi arrivano le mie opinioni, che potete accettare o no ma vi prego di leggere lo stesso. Cominciamo dal fondo, cioè dall’articolo 13. Ho forti dubbi che un controllo a priori funzioni su tutto il materiale sotto copyright, a meno naturalmente che si parli di Google che si memorizza tutto e se lo tiene in pancia. Come è possibile per un piccolo titolare di copyright fare accordi con tutti i siti che accettano file caricati dagli utenti? Consegna il materiale preventivamente, sperando che non vada in giro? (No, non basta avere una firma digitale sui contenuti. Basta sostituire un singolo frame del film oppure aggiungere un decimo di secondo di silenzio o ancora modificare leggermente la copertina per avere una checksum diversa senza modificare in pratica il contenuto). Viene chiesto di fare un controllo sui metadati? Vale la stessa cosa che ho detto qui sopra: semplicemente i motori di ricerca per recuperare i file piratati (ce ne sono, ce ne sono…) mostreranno anche i file che hanno leggere variazioni sul nome. Si chiederà ai piccoli siti di pagare Google per il servizio di controllo copyright? Spero proprio che non si voglia dare loro i soldi per pagare la Google Tax. Resto insomma dell’idea che sarebbe molto meglio far funzionare meglio la regolamentazione attuale a posteriori. Se io con un semplice Google Alert trovo ogni settimana nuovi siti che hanno una copia piratata dei miei libri, che ci vuole a un editore per fare la stessa cosa? Un’ultima cosa: immagino che i nostri giornali elimineranno tutte le foto “prese da Internet” nelle loro gallerie, il che in effetti non sarebbe un male… oppure pagheranno Facebook per il diritto di usare il nostro materiale. Ho controllato le condizioni d’uso: «Quando l’utente condivide, pubblica o carica un contenuto coperto da diritti di proprietà intellettuale (ad es. foto o video) in relazione o in connessione con i nostri Prodotti, ci concede una licenza non esclusiva, trasferibile, conferibile in sottolicenza, non soggetta a royalty e globale per la trasmissione, l’uso, la distribuzione, la modifica, l’esecuzione, la copia, la pubblica esecuzione o la visualizzazione, la traduzione e la creazione di opere derivate dei propri contenuti». Se non lo sapevate, sapevàtelo. (Se volete il mio parere, le frasi in grassetto non dovrebbero esserci. Ma visto che ci sono mi guardo bene dal pubblicare su Facebook qualcosa che valga davvero la pena. Per quanto riguarda questo specifico post, l’ho lasciato apposta con una licenza libera che permette anche l’uso commerciale, quindi non ci sono problemi di sorta.)

Image
Ah già, questa non era la direttiva contro le fake news, quindi un testo come questo non sarebbe comunque stato toccato

Per l’articolo 11, io ritengo idiota che una raccolta automatica di brani di news senza nessuna creatività — è fatta automaticamente, in fin dei conti… — sia considerata un’opera protetta da copyright e quindi si vogliano chiedere soldi a Google News. Presumo che a questo punto Google farebbe come in Spagna e saluterebbe tutti, ma questo non è un mio problema. Detto questo, non ho nulla in contrario a priori al fatto che gli editori cerchino di farsi dare qualche soldo dagli Over The Top per concedere loro il privilegio di mandare traffico verso i loro siti. Sappiamo tutti che lo spirito della direttiva era questo. Bene. Allora scrivete questa direttiva in modo più specifico, e soprattutto indicando specificatamente cos’è un aggregatore di notizie e non dicendo “non si può fare nulla tranne queste nostre benigne eccezioni” (vedi il testo dell’articolo 13). Per quanto mi riguarda un aggregatore (a) contiene qualcosa in più di titolo e catenaccio della notizia stessa — quindi tutti i giornali che vivono di clickbait possono tirare un sospiro di sollievo — e (b) non contiene un testo originale. Quest’ultima parte serve per distinguere una rassegna stampa di approfondimento (per me ok) da una mera raccolta (che è sì fuori copyright, ma per cui gli editori possono chiedere soldi all’aggregatore). Poi resto dell’idea che se Google e amici dessero metadati invece che soldi saremmo tutti più felici, ma questa è un’altra storia.

Resta il punto più spinoso e proprio per quello generalmente messo sotto il tappeto dai media: il diritto di panorama. Io non riesco davvero a capire perché se c’è un edificio pubblico che tutti possono vedere mentre passano per la strada non sia possibile fotografarlo, quindi farne un’immagine a scopo didascalico e non artistico, senza il permesso di chi ha progettato quell’edificio. Come direbbe Magritte, “Ceci n’est pas un palais”, non foss’altro che perché è a due dimensioni e non tre —è qualcosa di diverso da un modellino, tanto per dire, e la foto ha comunque un contesto. Eppure non è così. Bontà loro, i nostri governanti al momento permettono le foto senza fini di lucro, di cui però Wikipedia non se può fare nulla. Altre nazioni sono molto più generose e ammettono il diritto di panorama, anche se a dire il vero l’europarlamentare Jean-Marie Cavada e i suoi amici avevano già tentato nel 2015 di abolirlo ovunque nell’UE, per evitare «che i monopoli americani come Facebook e Wikimedia sfuggano al pagamento dei diritti ai creatori» (lo ha detto lui, al limite potete lamentarvi della mia traduzione fatta ad occhio senza che io parli francese). Detto in altri termini, il concetto di diritto d’autore per queste persone è qualcosa del tipo “se vuoi regalare il tuo lavoro creativo, fa’ pure, non te lo impediamo; ma devi avere la possibilità di impedire qualunque riuso anche indiretto del tuo materiale senza che ti paghino per il disturbo”. Il mio concetto, e credo quello della maggior parte dei wikipediani, è “il lavoro creativo è sacro, ed è giusto che chi lo faccia abbia il diritto di farsi pagare per il riuso; ma la documentazione del lavoro creativo dovrebbe essere libera per chiunque, e se qualcuno riesce a farci dei soldi buon per lui”. (Nota a margine: Arnaldo Pomodoro ha dato a Wikipedia una licenza esplicita per postare immagini di una qualunque sua opera esposta in un ambiente pubblico. Presumo che abbia compreso che è tutta pubblicità). Per la cronaca, il concetto degli Over The Top dovrebbe essere qualcosa tipo “regalaci il tuo materiale: a te non serve, ma noi sappiamo come farci dei soldi su, soldi che ci teniamo tutti noi”.

Se siete arrivati fin qui, dovrebbe esservi chiaro che il problema per me non è il concetto copyright, ma la sua applicazione attuale, che non è più a favore dell’autore salvo in pochi casi eccezionali. Sarebbe per esempio interessante sapere quanti iscritti alla SIAE ricavino più di 13000 euro l’anno (mille al mese più tredicesima, come un operaio specializzato) di royalties. Il guaio è che la narrazione è nelle mani di chi in effetti sul copyright ci guadagna eccome, anche se autore non è, e quindi non vuole che si stia a pensare a cosa succede davvero. Ecco, cercate invece di azionare il cervello.

Image

Wikipedia, l’enciclopedia libera, si è auto-oscurata nella sua edizione italiana per protestare contro la riforma del copyright nel mercato unico digitale europeo

Il 5 luglio 2018 il Parlamento europeo in seduta plenaria deciderà se accelerare l’approvazione della direttiva sul copyright. Tale direttiva, se promulgata, limiterà significativamente la libertà di Internet.

Anziché aggiornare le leggi sul diritto d’autore in Europa per promuovere la partecipazione di tutti alla società dell’informazione, essa minaccia la libertà online e crea ostacoli all’accesso alla Rete imponendo nuove barriere, filtri e restrizioni. Se la proposta fosse approvata, potrebbe essere impossibile condividere un articolo di giornale sui social network o trovarlo su un motore di ricerca. Wikipedia stessa rischierebbe di chiudere.

La proposta ha già incontrato la ferma disapprovazione di oltre 70 studiosi informatici, tra i quali il creatore del web Tim Berners-Lee (qui), 169 accademici (qui), 145 organizzazioni operanti nei campi dei diritti umani, libertà di stampa, ricerca scientifica e industria informatica (qui) e di Wikimedia Foundation (qui).

Per questi motivi, la comunità italiana di Wikipedia ha deciso di oscurare tutte le pagine dell’enciclopedia. Vogliamo poter continuare a offrire un’enciclopedia libera, aperta, collaborativa e con contenuti verificabili. Chiediamo perciò a tutti i deputati del Parlamento europeo di respingere l’attuale testo della direttiva e di riaprire la discussione vagliando le tante proposte delle associazioni Wikimedia, a partire dall’abolizione degli artt. 11 e 13, nonché l’estensione della libertà di panorama a tutta l’UE e la protezione del pubblico dominio.

https://meta.wikimedia.org/wiki/SaveYourInternet

La comunità italiana di Wikipedia

Questo è il testo integrale del comunicato, unica pagina visibile su Wikipedia in lingua italiana. Tutto quanto viene riportato è a parere non solo mio veritiero (checché ne dicano gli editori) e l’unica cosa da fare è agire per evitare che tutto il web subisca gravi danni. Proposte come la link tax hanno creato solo danni ovunque siano state approvate.

È possibile dunque contattare il proprio rappresentante all’europarlamento e far sentire la propria voce e la propria opinione.

Image
Image

Aggiornamento: Ecco come hanno votato i vari europarlamentari.

Il grande giornalismo d’inchiesta

Tuesday, 8 May 2018 07:42 UTC

Tutto pur di pubblicare qualcosa di diverso

Ieri Valentino Di Giacomo ha scritto sul Mattino, vale a dire uno tra i principali quotidiani italiani, un articolo il cui incipit è

«Angelino Sempreinpiedi», ministro dei record. Il titolare della Farnesina, Alfano, con 1836 giorni consecutivi alla guida di un dicastero comanda infatti questa particolare classifica nella storia della Repubblica italiana. Mai nessuno ci era riuscito per così tanti giorni.

Come capita spesso nel Belpaese, gli altri giornali si sono affrettati a copiare la notizia, perché vuoi mica rimanere dietro gli altri e perdere preziosi lettori: ecco così Il Giornale, TGCom, Tiscali News, Il Fatto Quotidiano, HuffPost, Today, TPI

Quest’ultimo in realtà non deve fare parte di questa lista della vergogna: è l’unico infatti il cui redattore ha azionato il cervello e ha specificato “della seconda Repubblica”. Vi ricordate del divo Giulio? Andreotti è stato ministro nei seguenti governi (courtesy of Wikipedia, naturalmente):

Totale: 4909 giorni consecutivi (4910 se contiamo anche l’ultimo), di cui 2565 consecutivi allo stesso ministero. (Angelino è passato dagli Interni agli Esteri con Gentiloni).

Tra l’altro, già l’anno scorso Salvo Toscano sul Foglio scriveva

Due certezze in questi anni: Alfano e la sua poltrona. Sempre al governo, ministro più longevo della Repubblica.

La mia domanda a questo punto è molto semplice. Abbiamo un certo numero di italici giornalisti che non è capace di fare quello che sarebbe il suo mestiere, cioè scrivere notizie non dico importanti ma almeno suffragate da dati nemmeno poi difficili da trovare, oppure siamo solo di fronte a un banale caso di piaggeria nei confronti di Angelino Alfano?

P.S.: mi segnalano che già venerdì scorso, su Propaganda Live (trasmissione de La 7) era stato segnalato questo “record”. Ci sarà bene un motivo perché da anni io non mi fido di qualunque cosa venga raccontato dai nostri media: per fortuna non sono un complottista e non credo che sia tutto un diabolico piano per rimbesuire i cittadini. Lo sono già lo stesso.

Image